
포지션이 과거의 상위 구간에 있다거나 지표가 평균보다 두 표준편차 높다는 말을 들으면 앞으로 가격이 움직일 방향까지 알려 주는 것처럼 느껴진다. 그러나 현재의 위치와 이후의 결과는 다른 자료로 확인해야 한다.
숫자를 쓸모없다고 볼 필요는 없다. 무엇을 기준으로 얼마나 특이한 상태인지 정리하는 데 유용하다. 그 숫자에 들어 있지 않은 예측을 덧붙이지 않는 것이 중요하다.
z점수는 기준 평균에서의 거리이고, 백분위는 기준 분포 안의 위치다. 미래 상승 확률을 알려면 이후 결과와의 관계를 별도로 검증해야 한다.
1. z점수의 분모가 무엇인지 확인한다
z점수는 값에서 기준 평균을 빼고 기준 표준편차로 나눈 값이다. NIST의 표준화 설명도 이 계산을 설명한다.
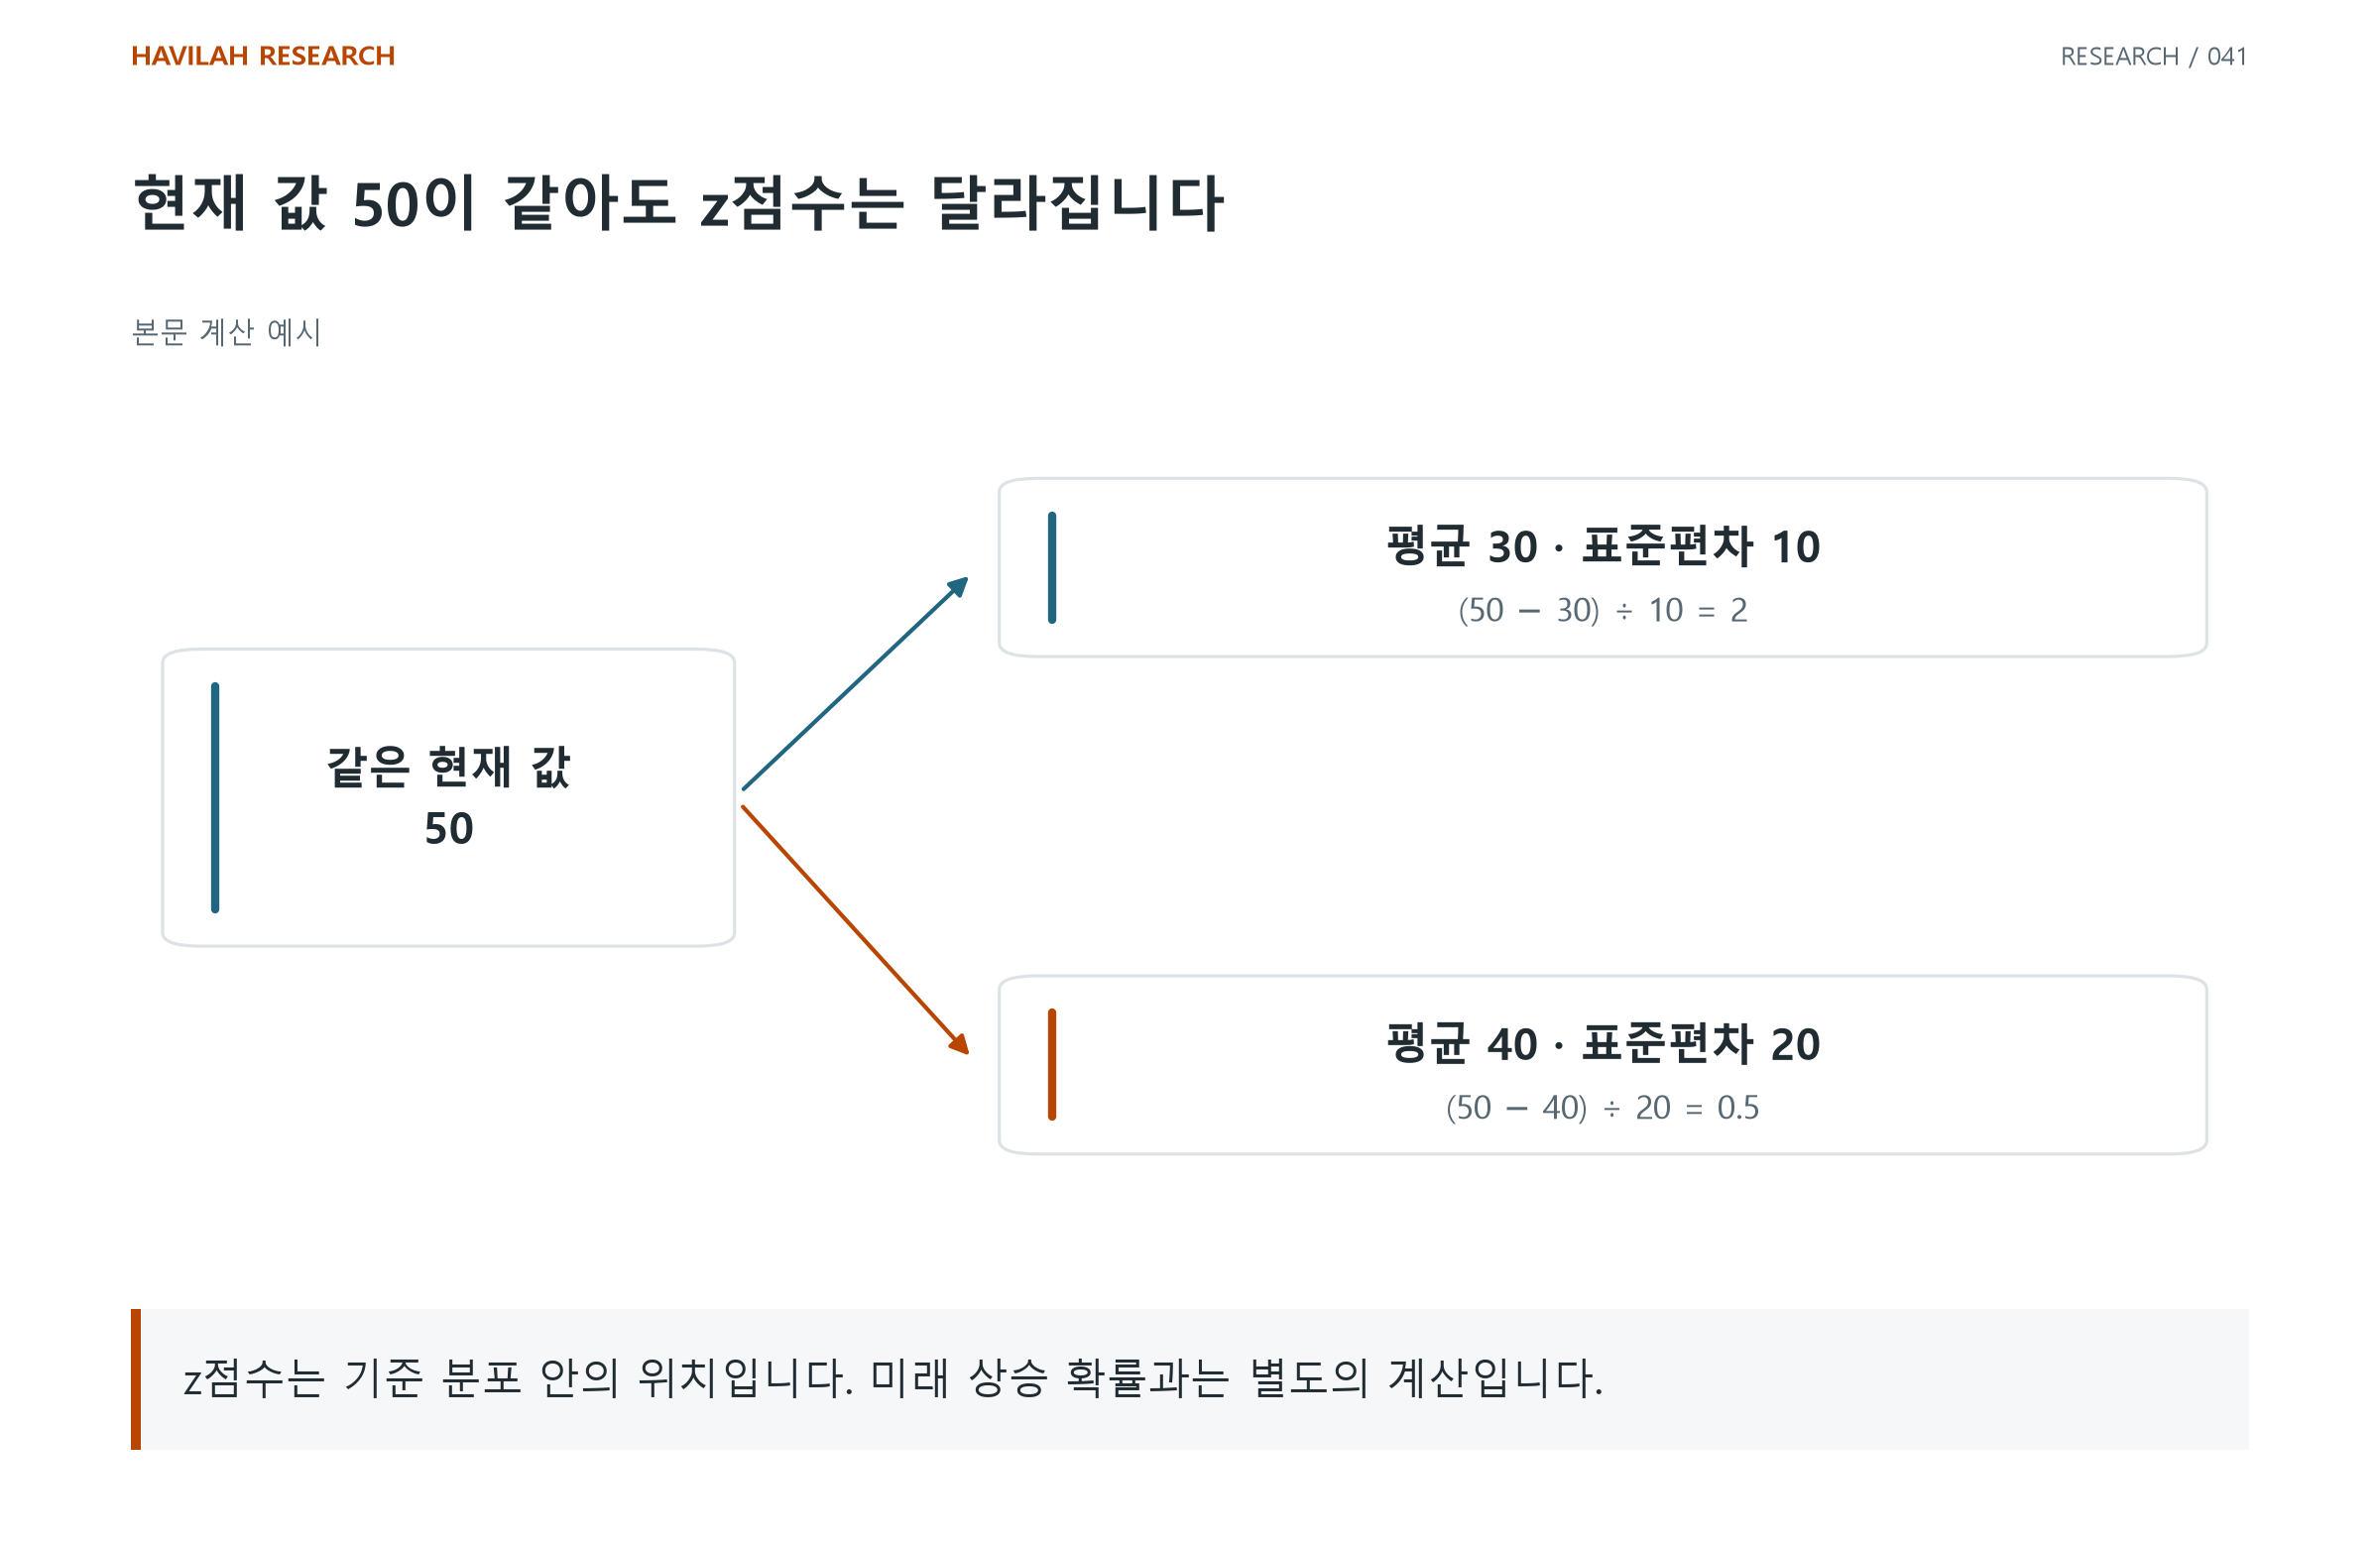
가상으로 현재 값이 50, 과거 기준 평균이 30, 표준편차가 10이면 z점수는 (50 − 30) ÷ 10 = 2다. 평균보다 표준편차 두 개만큼 높은 값이라는 뜻이다.
같은 현재 값 50이라도 다른 기준 기간의 평균이 40, 표준편차가 20이면 z점수는 0.5다. 현재 값이 같아도 기준 표본이 바뀌면 표준화한 위치가 바뀐다. 기준 기간과 집계 단위, 표준편차의 계산 방식을 같이 기록한다.
2. 백분위는 무엇을 줄 세웠는지 묻는다
과거 자료 안에서 높은 위치라는 말과 기업들 사이에서 높은 위치라는 말은 다르다. 자신의 과거와 비교한 순위인지, 같은 날짜의 다른 대상과 비교한 순위인지 먼저 확인한다.
NIST의 백분위 설명은 정렬된 자료의 위치와 보간 방식에 따라 백분위를 계산하는 방법을 다룬다. 표본이 작거나 같은 값이 많으면 계산 방식에 따른 차이도 확인할 필요가 있다.
과거 포지션 자료 100개 중 현재 값 이하가 80개라면, 그 표본의 80%가 현재 값 이하였다고 말할 수 있다. 이것이 앞으로 주가가 오를 확률 80%를 뜻하지는 않는다. 순위에 사용한 변수와 예측하려는 사건을 구분한다.
3. 정규분포 표를 쓰면 분포 가정도 남긴다
표준정규분포에서 z=2 이하의 누적 확률은 약 97.7%다. 이는 그 분포를 따르는 변수의 위치에 관한 계산이다. 표준화만 했다고 실제 금융 자료가 정규분포를 따르게 되는 것은 아니다.
치우침이나 두꺼운 꼬리가 있는 자료에서는 같은 z점수의 실제 관측 비중이 다를 수 있다. 계절성과 구조 변화가 섞인 긴 표본도 현재 상태의 비교 기준으로 적절한지 살펴본다.
97.7%를 주가 상승·전략 성공·손실 회피의 확률로 바꾸려면 해당 사건에 관한 별도 근거가 필요하다. 정규분포 표는 그 연결을 자동으로 만들지 않는다.
4. 예측하려면 신호 뒤에 나온 결과를 연결한다
‘포지션 지표가 이 구간이면 이후 3개월 수익이 어땠는가’처럼 대상·기준·결과 기간을 정한다. 신호 시점에 이용할 수 있었던 자료로 구간을 분류하고, 그 이후 결과를 비교한다.
높은 평균 수익과 높은 상승 빈도도 같은 지표가 아니다. 손실 크기·거래 비용·표본 수와 불확실성을 같이 읽는다. 결과를 보고 잘 맞는 구간만 고르면 검증과 선택이 섞인다.
현재 상태를 요약한 숫자와 이후 성과의 관계는 검증해야 할 가설이다. 다른 기간에서도 관계가 남는지, 실제 거래 조건에서도 의미가 있는지 확인한다.
5. 서로 다른 기준의 점수를 바로 비교하지 않는다
한 지표는 6개월, 다른 지표는 5년을 기준으로 계산했다면 같은 z점수라도 같은 시장 상태를 의미하지 않는다. 표본 빈도와 대상도 다를 수 있다. 값이 낮아졌다면 실제 입력이 변했는지, 평균과 표준편차가 변했는지도 나누어 본다.
‘무엇의 값인가?’, ‘어떤 표본과 비교했는가?’, ‘다음에 무엇이 일어날 것이라는 근거가 따로 있는가?’를 적는다. 거래에 사용할 경우에는 그 지표가 자신의 자산과 어떤 관계를 갖는지도 확인한다.
특이한 상태라는 관찰에서 유리한 거래라는 결론으로 넘어갈 때, 빠진 연결고리를 찾는 것이 통계 숫자를 읽는 핵심이다.