
현재 시장과 닮은 과거를 찾으면 다음 움직임을 예상할 단서를 얻을 것처럼 보인다. 하지만 무엇이 닮았는지를 정하는 단계에도 많은 선택이 들어 있다.
가격·거래량·변동성 중 어떤 정보를 넣고 어느 기간을 비교하느냐에 따라 과거 사례가 바뀐다. 유사도는 중립적인 검색 결과라기보다 검증해야 할 모형의 일부다.
과거 사례의 유사성은 미래 결과가 유사하다는 증거가 되기 전에 별도의 검증이 필요하다.
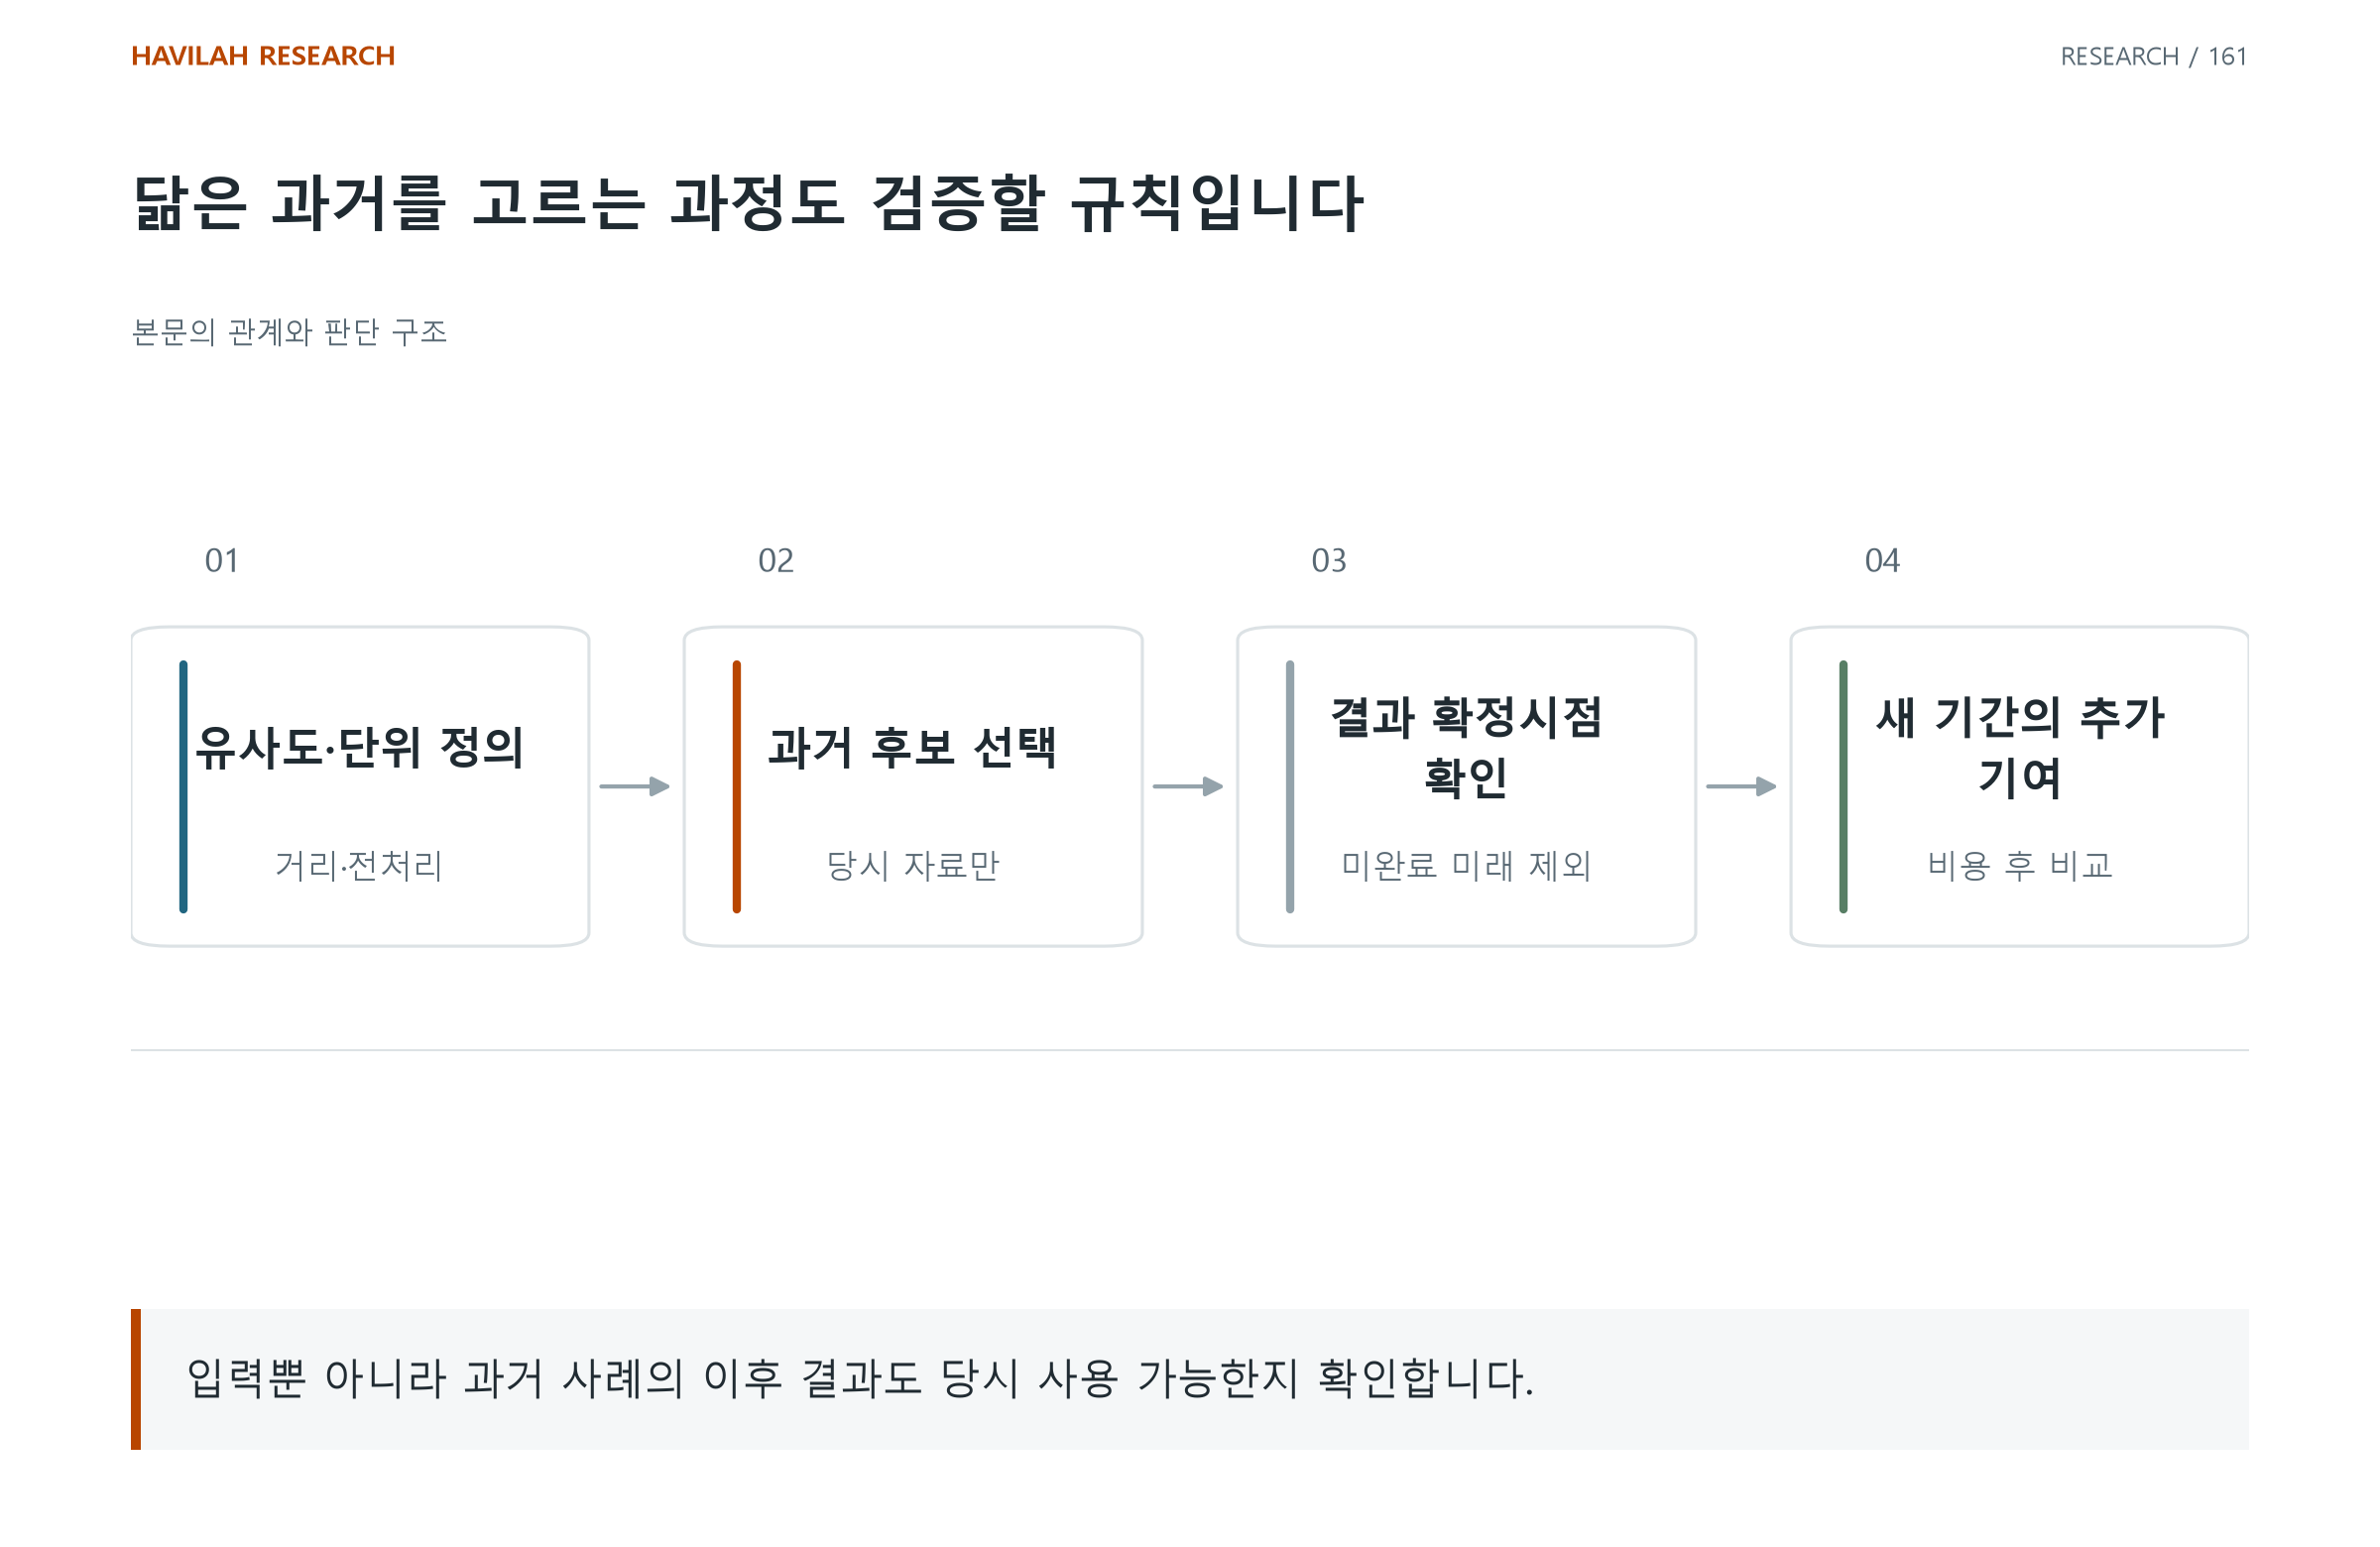
1. 닮았다는 표현을 계산 기준으로 바꾼다
입력 변수와 관찰 기간, 거리의 계산법과 선택할 사례 수를 적는다. 사람의 눈으로 닮았다고 보는 차트와 숫자로 가까운 자료는 다를 수 있다.
scikit-learn의 최근접 이웃 설명은 새 관측치와 가까운 학습 사례를 찾아 결과를 예측하는 방법을 설명한다. 이 방법을 시장에 적용했다는 사실만으로 금융 예측력이 확인되지는 않는다.
2. 단위가 사례 선택을 지배하지 않는지 확인한다
가격 수준과 수익률, 거래량은 숫자의 크기가 다르다. 가공하지 않고 거리를 계산하면 큰 단위의 변수가 사실상 다른 정보를 덮을 수 있다.
표준화하거나 가중치를 바꿔도 어떤 차이를 중요하게 볼지 선택한 것이다. 전처리와 거리 기준도 전략의 가정으로 기록해야 한다. 결과가 좋아 보인 기준만 골랐다면 그 선택 횟수도 연구 이력에 포함한다.
3. 과거 사례의 결과가 언제 확정되는지 본다
오늘과 가까운 과거 날짜를 골라도 그 사례의 다음 10일 결과는 오늘 아직 끝나지 않았을 수 있다. 입력 날짜가 과거라는 이유만으로 이후 결과까지 사용할 수 있는 것은 아니다.
판단 시점에 입력과 목표값이 모두 알려진 사례만 학습에 넣는다. 예측하려는 기간이 겹치면 표본 간 의존과 학습·평가 경계도 함께 검토한다.
4. 전처리부터 평가 자료와 분리한다
전체 기간의 평균과 변동성으로 입력을 조정한 뒤 학습 기간을 나누면 평가 기간의 정보가 이미 들어갈 수 있다. 학습 자료로 정한 변환을 평가 자료에도 같은 방식으로 적용한다.
scikit-learn의 정보 누출 안내는 평가 자료가 전처리·변수 선택에 들어갈 때 성과가 과대평가될 수 있음을 설명한다. 분리해야 할 것은 모형을 맞추는 단계뿐 아니라 자료를 가공하는 단계도 포함한다.
5. 유사도와 실제 거래의 추가 기여를 확인한다
시간 순서에 맞춘 평가에서 단순한 기준과 비교한다. 사례 수와 기간을 바꿔 본 결과, 거래비용·회전율과 처음 보는 상황에서의 제한도 남긴다.
잘 닮은 사례를 찾는 능력과 그 사례로 순수익을 만드는 능력은 다르다. AI라는 이름보다 어떤 정보가 어떤 조건에서 추가 기여를 했는지 확인해야 한다.
적용해 볼 질문
유사도를 결정한 변수·기간·단위·사례 수를 기록했는가?
학습 사례의 이후 결과가 당시 이미 확정되어 있었는가?
전처리까지 분리한 평가에서 단순 기준보다 추가 기여가 있는가?