
상단이나 하단을 잘 잡는다는 지표를 보면 가장 먼저 적중률에 눈이 간다. 그러나 “무엇을 맞혔는가”와 “그 신호로 언제 어떻게 거래했는가”가 빠지면 숫자의 의미가 달라진다.
신호의 분류 성능은 평가할 수 있다. 그 결과를 수익으로 연결하려면 사건의 정의·놓친 사례·신호 확정 시점과 체결 이후의 손익까지 이어 봐야 한다.
분류 지표의 분모와 정보 시점을 확인하고, 실제 거래 성과를 별도로 검증한다.
1. 정밀도와 재현율은 다른 질문에 답한다
정밀도는 나온 양성 신호 중 실제 양성으로 분류된 비율이다. 재현율은 전체 실제 양성 중 신호가 포착한 비율이다. scikit-learn의 설명은 두 지표의 정의와 임계값에 따른 변화를 구분한다.
시장에서는 양성을 어떻게 정했는지 먼저 읽어야 한다. 이후 며칠의 가격, 어느 변동 폭, 어떤 중복 처리로 변곡을 정의했는지에 따라 같은 차트에서도 평가가 달라질 수 있다.
2. 높은 정밀도와 놓친 사건을 함께 본다
가상 평가 구간에 정의상 사건이 100개 있었다고 하자. 지표는 10번 신호를 냈고, 그중 9번이 사건과 일치했다. 사건과 신호의 대응은 한 번씩만 세는 단순 예시다.
평가 질문 | 계산 | 결과 |
|---|---|---|
나온 신호는 얼마나 맞았나 | 9 ÷ 10 | 정밀도 90% |
전체 사건은 얼마나 포착했나 | 9 ÷ 100 | 재현율 9% |
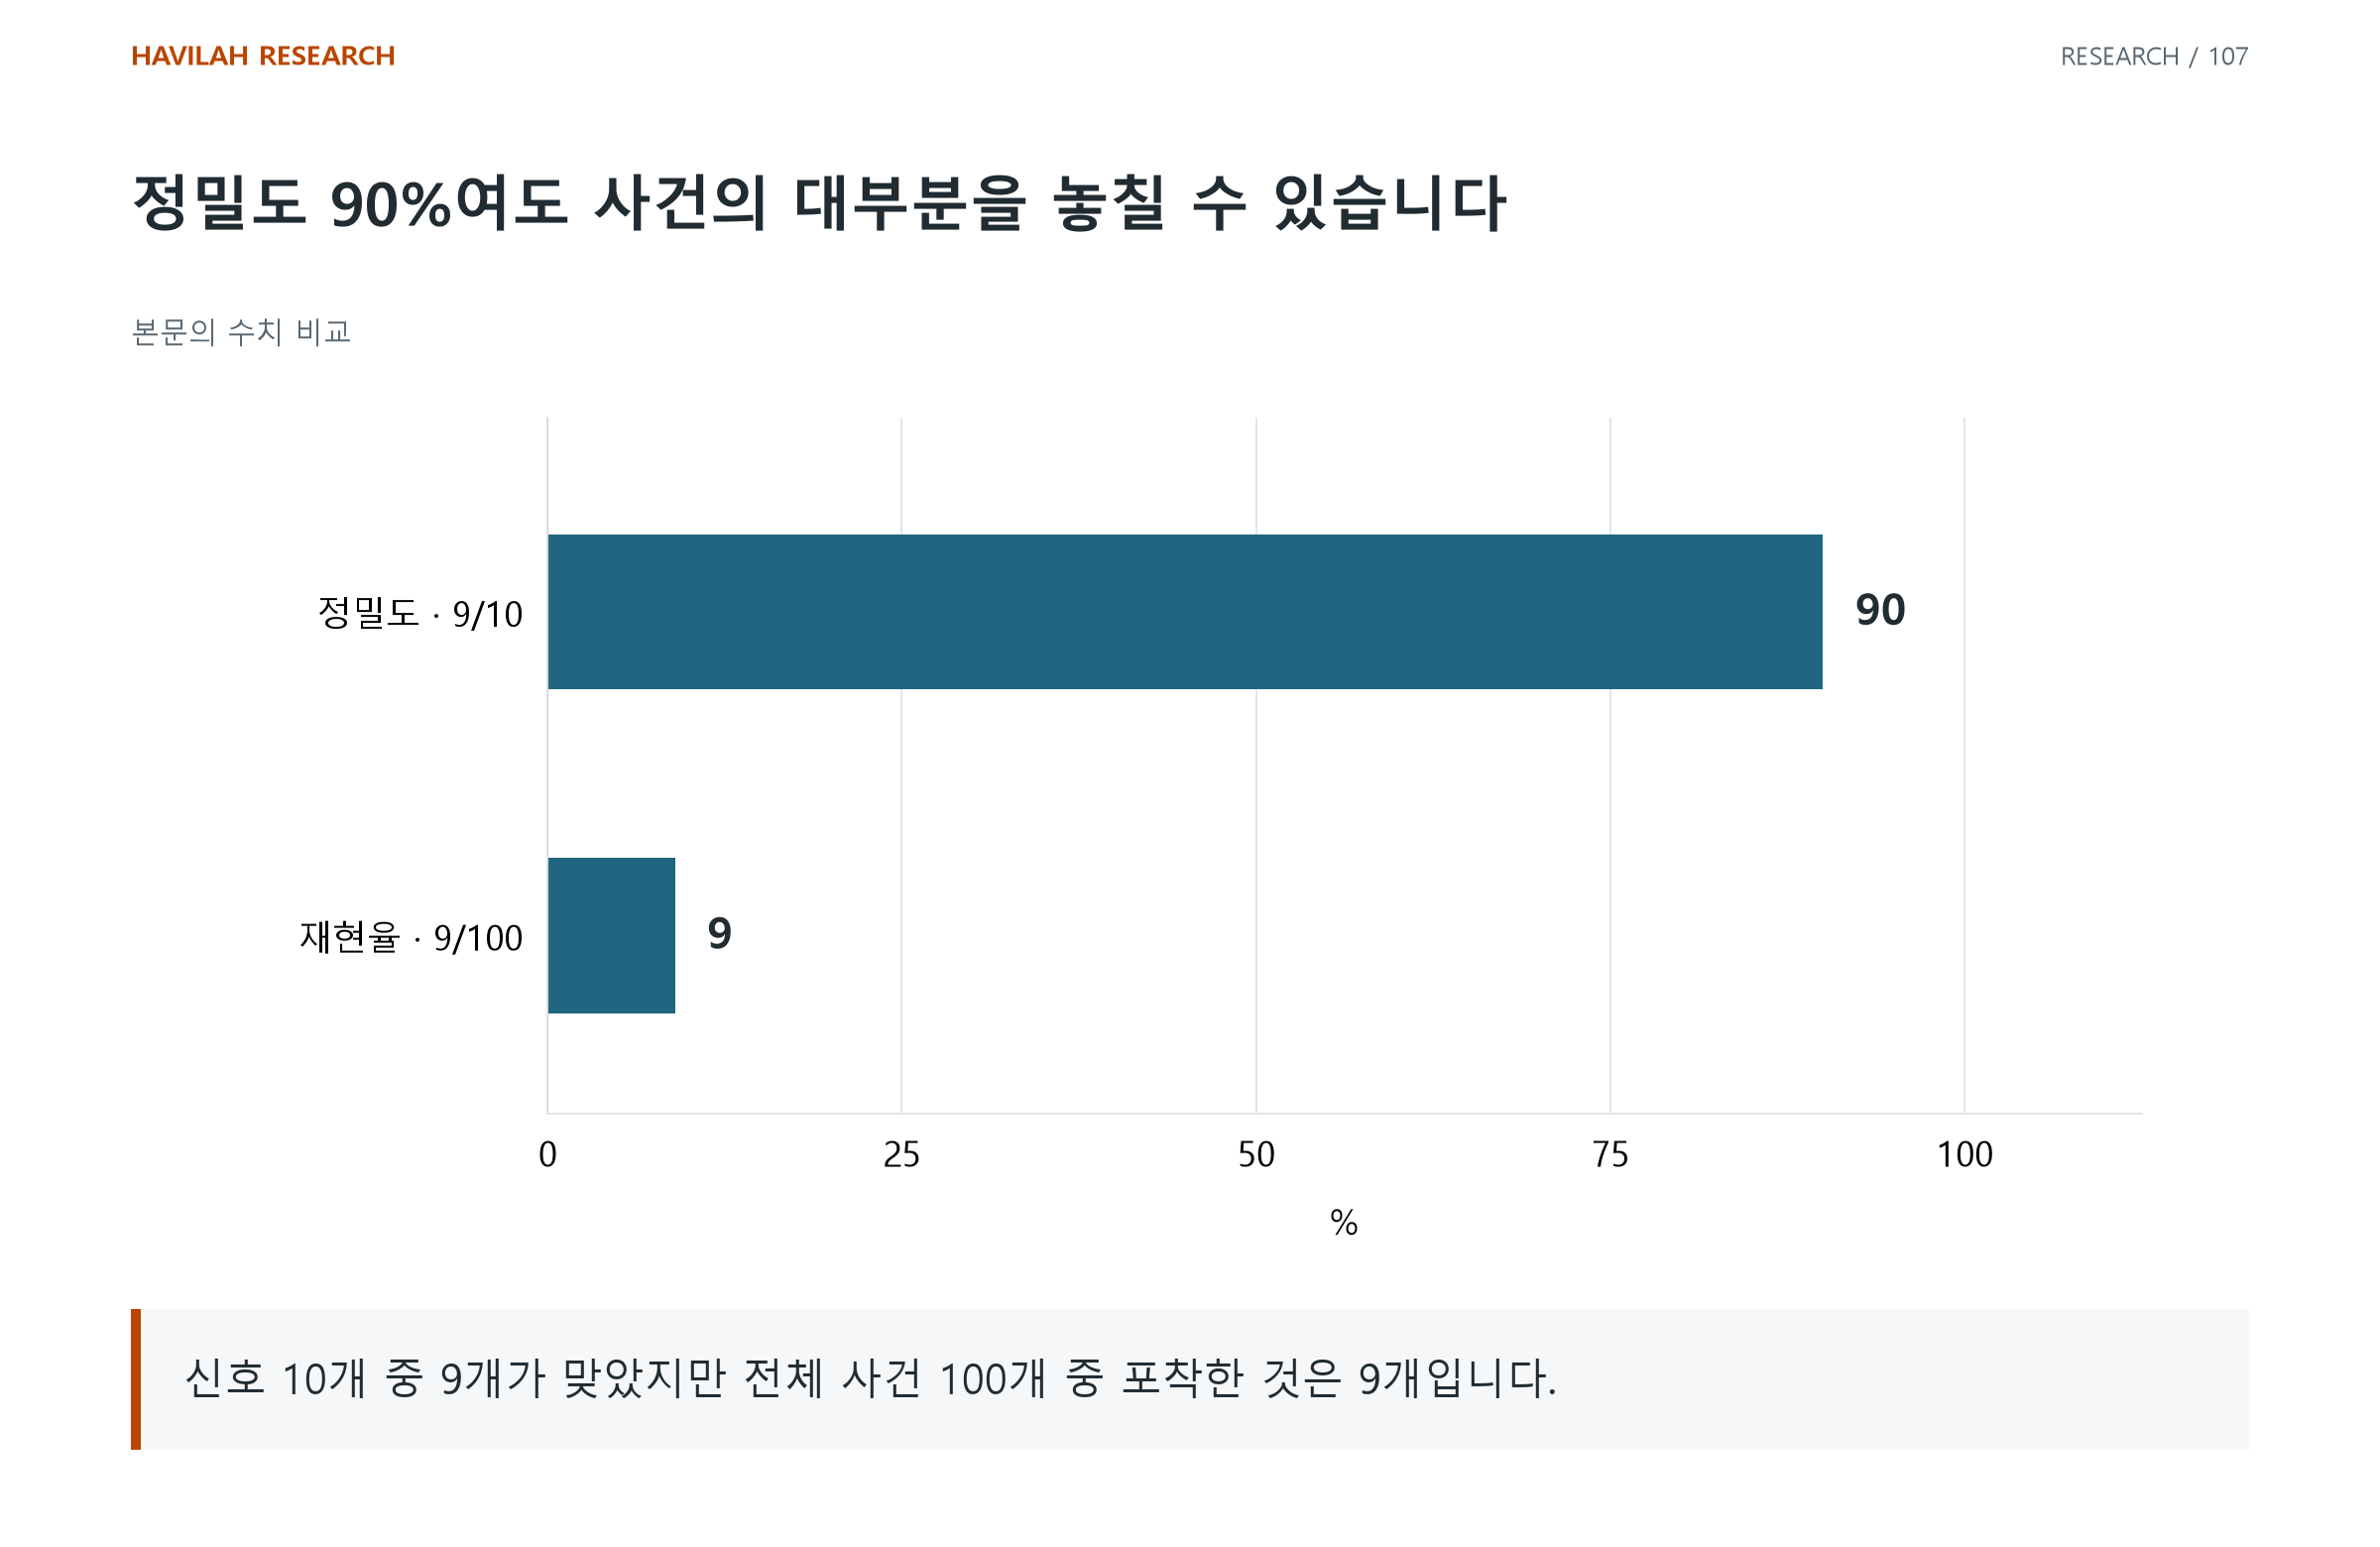
91개 사건은 포착하지 못했다. 적은 신호를 내는 목적에는 맞을 수 있지만 시장의 모든 주요 움직임을 잡았다는 뜻은 아니다. 어떤 목적에 맞는 성능인지 분모와 함께 제시한다.
3. 변곡이 발생한 시간과 확인된 시간을 나눈다
과거 차트의 꼭지에 표시가 있어도 그 자리에 실시간으로 신호를 알 수 있었는지는 별도 문제다. 이후 봉을 보고 변곡을 확인했다면 거래에 사용할 정보는 확인된 시점부터다.
평가용 정답을 미래 가격으로 만드는 일과 미래 가격을 입력·신호·과거 체결에 사용하는 일을 구분한다. 신호 발생·확정·수신·주문·체결 시간을 연결해, 과거에 찍힌 위치를 매매 가격으로 쓰지 않는다.
4. 분류가 맞은 거래도 손실일 수 있다
정의한 변곡과 일치해도 진입이 늦거나 목표 폭이 작고 비용이 크면 거래 손익은 달라진다. 청산 규칙·보유 기간·미체결과 노출, 예상 가격과 실제 체결 가격의 차이를 연결해야 한다.
반대로 분류상 실패한 사례가 특정 거래 규칙에서는 이익일 수도 있다. 신호의 정답 여부와 계좌의 손익을 같은 열로 취급하지 않는다. 실제 손익을 직접 계산한다.
5. 평가 구간과 선택 과정을 보존한다
같은 자료에서 여러 임계값·사건 정의를 고른 뒤 좋은 숫자만 남기면 표본 밖에서도 유지될지 알기 어렵다. 기준을 고른 기간과 평가 기간, 시도한 설정·신호 수를 함께 적는다.
희소한 사건에서는 작은 표본과 기간 선택도 결과를 크게 바꿀 수 있다. 한 비율을 현재 신호의 확정 확률로 받아들이기보다, 정의를 고정한 다른 기간의 분류와 거래 결과를 확인한다.
적용해 볼 질문
양성 사건의 정의와 정밀도·재현율의 분모는 무엇인가?
차트의 표시 위치와 실제로 신호를 알 수 있었던 시간은 같은가?
분류 성능과 비용을 반영한 거래 성과를 따로 계산했는가?