
수익률 예측에 ‘90% 예측구간’이 붙으면 오늘의 전망을 90%만큼 믿어도 될 것 같다. 하지만 같은 이름의 구간도 무엇을 예측하고 어떤 자료로 폭을 정했는지에 따라 의미가 달라진다.
전체적으로 실제 값을 잘 담는 구간이 유독 시장이 거친 날에는 자주 빗나갈 수 있다. 투자에 사용할 때 필요한 것은 신뢰도 숫자 하나보다, 그 숫자가 어떤 반복과 조건에서 성립하는지 이해하는 일이다.
전체 예측의 90%를 담는다는 기준은, 모든 시장 상황에서 각각 90%의 포함 확률을 보장한다는 뜻이 아니다.
1. 평균의 추정과 다음 결과의 예측을 구분한다
‘평균 수익률이 어느 범위에 있는가’와 ‘다음 하루의 수익률이 어느 범위에 나올까’는 다른 질문이다. 평균을 정밀하게 추정해도 개별 하루의 결과는 크게 흔들릴 수 있다.
NIST의 예측구간 설명은 평균 반응의 추정 오차와 새 관측 자체의 변동을 구분한다. 평균에 관한 신뢰구간을 다음 수익률의 예상 범위로 바꿔 읽으면 변동을 작게 볼 수 있다.
예측 대상의 기간도 적어야 한다. 내일 종가까지의 수익률을 담는 구간이 장중 최대 손실이나 한 달 내내 머물 가격 범위를 알려 주지는 않는다.
2. 따로 남겨 둔 예측 오차로 폭을 정한다
한 가지 방법이 분할 컨포멀 예측이다. 모형을 학습한 뒤 고정하고, 학습에 쓰지 않은 보정 자료에서 ‘실제 값과 예측값의 차이’를 측정한다. 여기서는 그 차이의 절댓값으로 구간의 폭을 만든다.
설명용으로 보정 오차 19개를 작은 순서로 정렬하자. 첫 16개는 0.2부터 1.7까지 0.1 간격이고, 마지막 세 개는 2.5·3.2·5.0이다. 단위는 모두 수익률의 퍼센트포인트(%p)다. 실제 시장 측정값이 아니다.
목표 포함률이 90%라면 사용할 순위는 (19 + 1) × 0.90을 올림한 18번째다. 따라서 폭은 3.2%p이고, 새 예측값이 +1.0%라면 구간은 −2.2%~+4.2%가 된다.
이 유한 표본의 순위 보정은 Angelopoulos·Bates의 설명과 정리 D.1에 나온다. 단순히 과거 오차의 평균을 더하거나 임의의 백분위 보간을 적용하는 계산과 구분해야 한다.
19개는 순서를 보여 주기 위한 작은 예제다. 금융 예측에 충분한 표본 수를 권하는 숫자가 아니다. 보정 자료를 보고 모형과 오차 정의를 계속 고르면 처음에 남겨 둔 자료의 역할도 달라진다.
3. 전체 90% 뒤에 특정 상황의 45%가 숨을 수 있다
기본 보장에는 보정 자료와 새 관측의 교환가능성이 필요하다. 관측의 순서를 바꿔도 결합 확률분포가 달라지지 않는 성질이다. 같은 분포에서 독립적으로 뽑은 자료는 이를 만족하는 한 경우다.
그 조건 아래의 보장은 보정 자료와 새 관측이 달라지는 반복을 평균 낸 포함 확률이다. 이미 정해진 오늘의 입력마다 90%를 약속하는 조건부 보장과는 다르다. 주변적·조건부 포함률의 비교는 이 차이를 다룬다.
다음은 그 차이를 보여 주는 별도의 가상 집계다. 실제 예측 결과도, 앞의 19개 오차에서 얻은 결과도 아니다.
예측할 때 구분한 상황 | 예측 수 | 실제 값이 구간 안에 든 수 | 관측 포함률 |
|---|---|---|---|
조용한 상황 | 900회 | 855회 | 95% |
변동이 큰 상황 | 100회 | 45회 | 45% |
전체 | 1,000회 | 900회 | 90% |
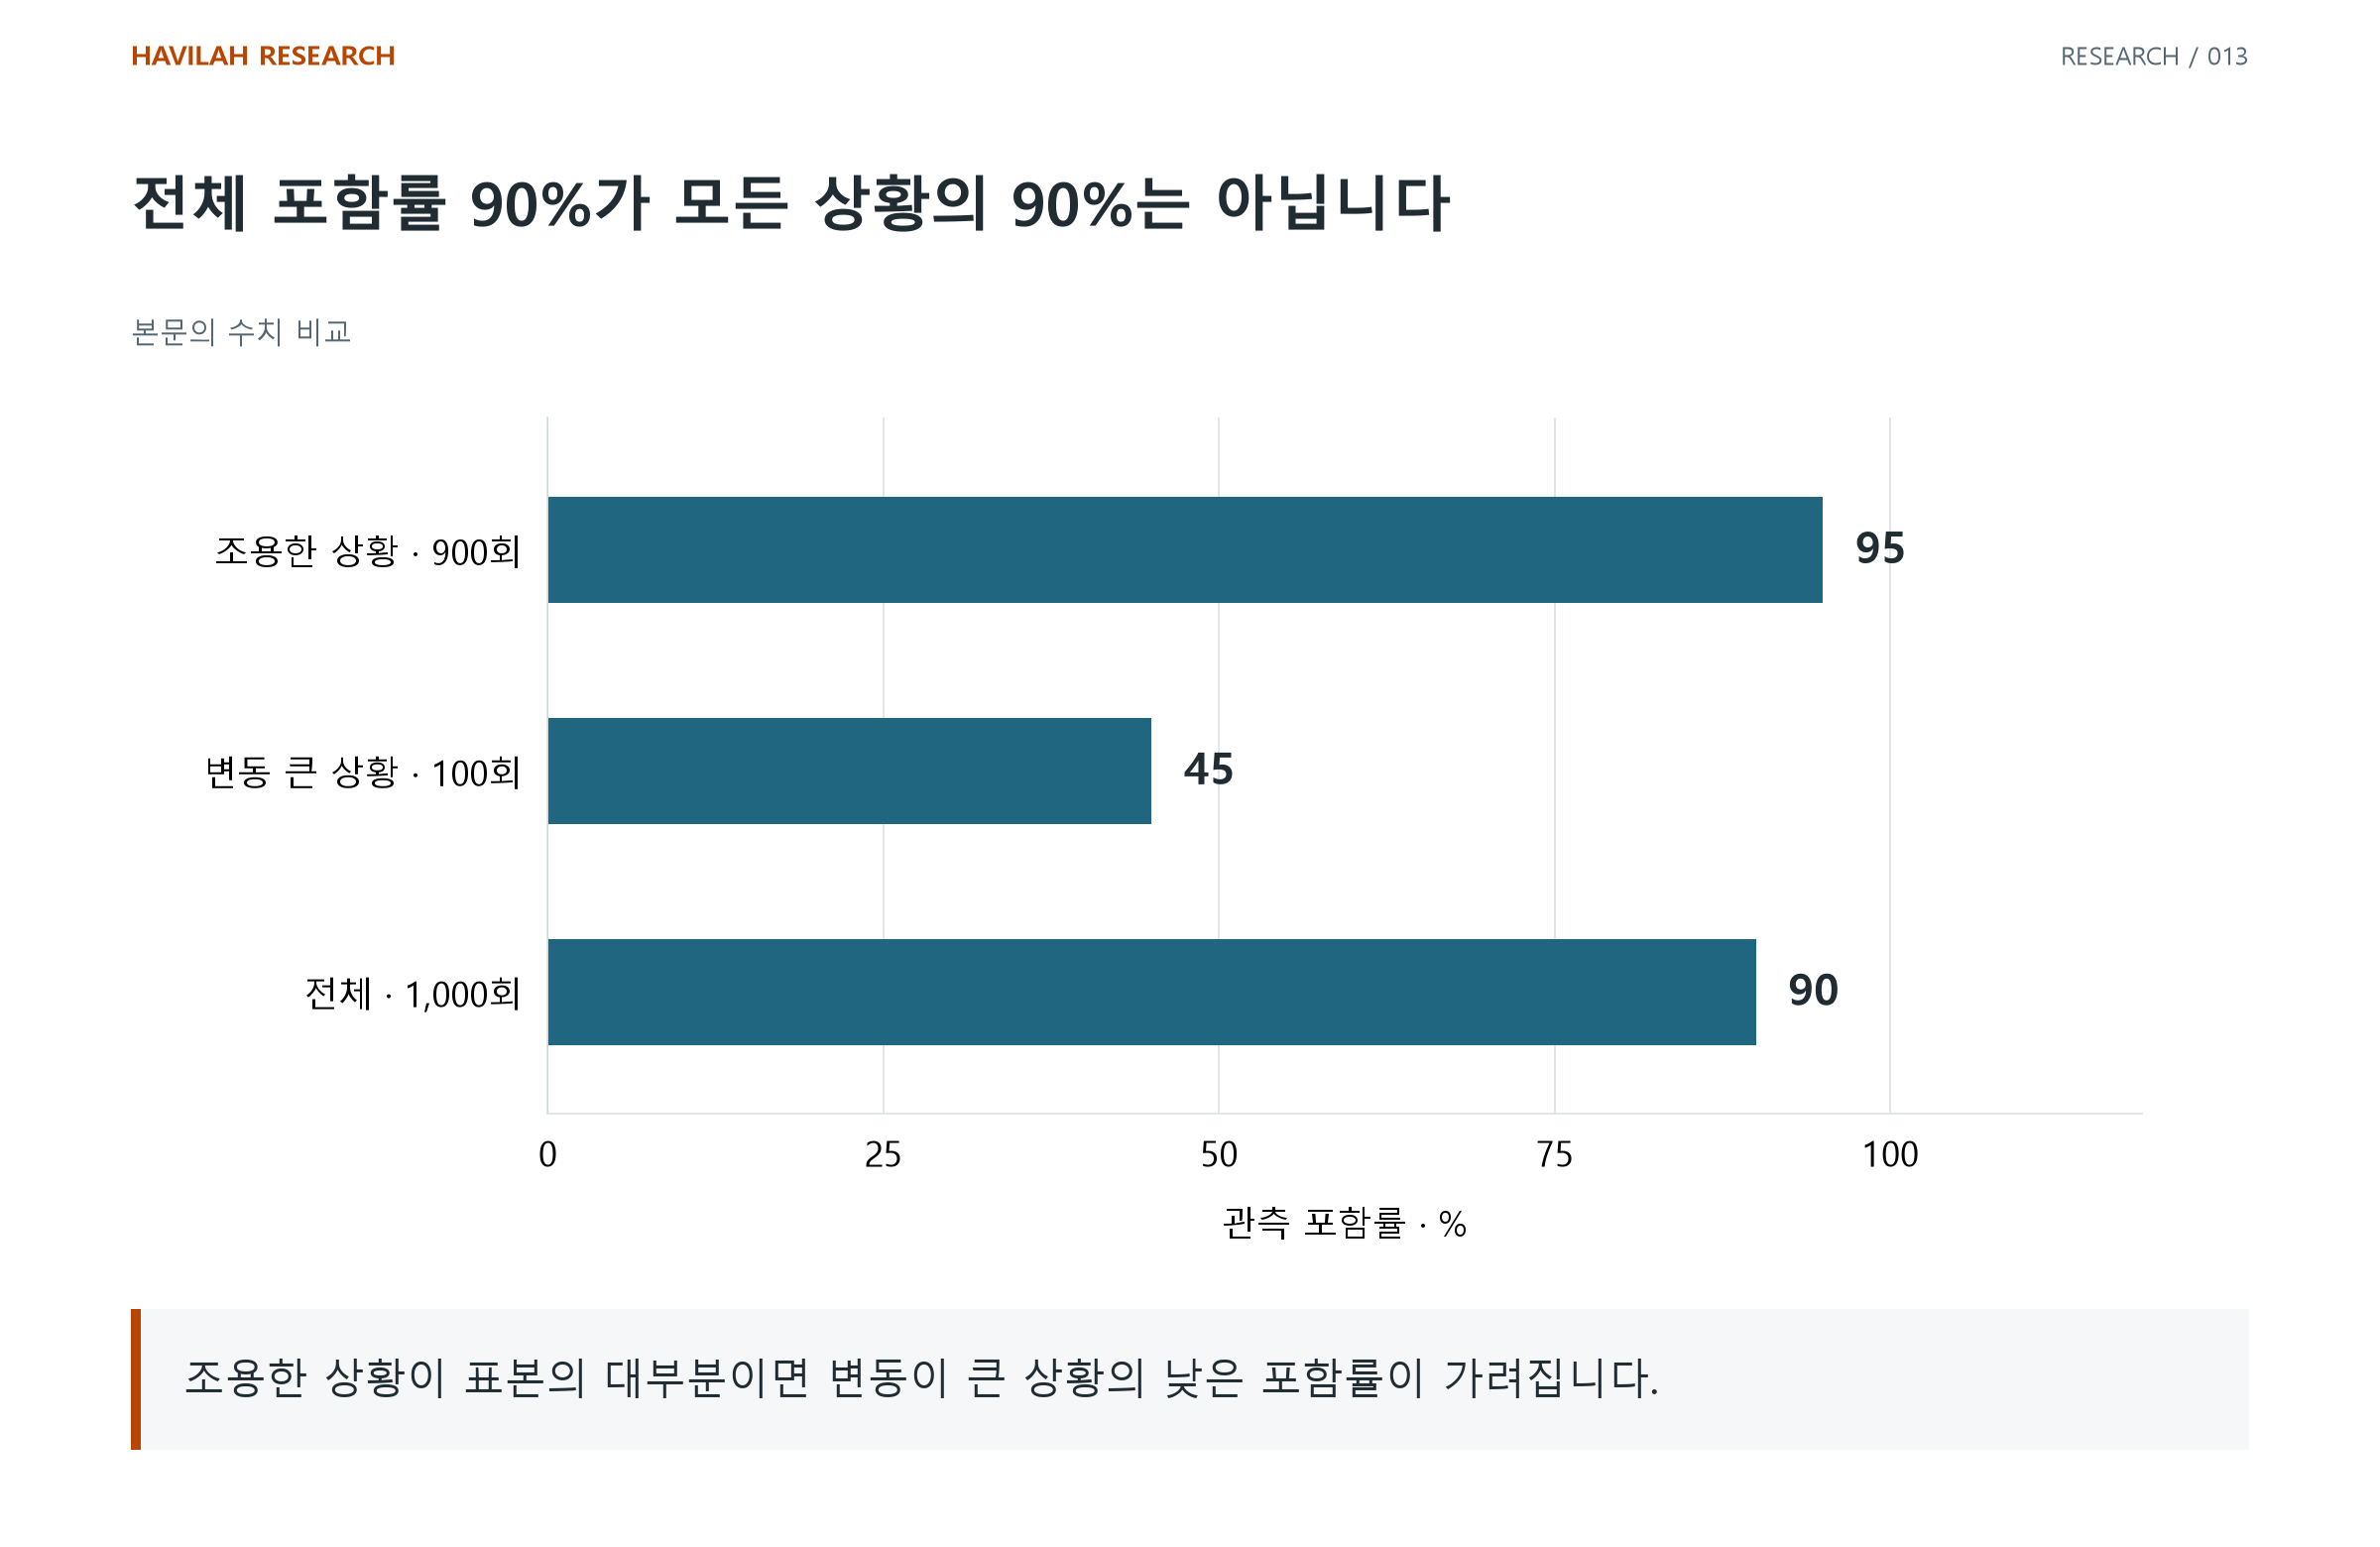
전체 숫자는 목표에 맞지만, 변동이 큰 상황에서 벗어난 55회가 남는다. 가장 필요할 때 약한 구간도 전체 성적표에서는 좋아 보일 수 있다. 전체 포함률과 함께 상황별 표본 수·포함률을 봐야 하는 이유다.
4. 최근 자료로 갱신해도 보장의 뜻을 다시 확인한다
시장에서는 오차가 연속해서 커지거나 자료의 분포가 바뀔 수 있다. 최근 자료로 보정하는 선택은 이런 변화에 대응할 방법이지만, 창을 짧게 바꾸었다고 교환가능성이 자동으로 생기지는 않는다.
Gibbs·Candès의 적응형 컨포멀 연구는 구간을 벗어난 결과를 반영해 보정 수준을 갱신한다. 논문 4.1절의 결과는 해당 갱신 규칙과 경계 처리 아래에서 장기간의 관측 포함 빈도를 관리한다. 매 시점의 조건부 포함 확률을 똑같이 보장하는 결과는 아니다.
따라서 ‘변화에 적응한다’는 설명을 읽을 때는 무엇을 갱신하고 어떤 기간의 오차를 관리하는지 묻는다. 특정 방법의 장기 보장을 임의의 이동창 구현에 그대로 붙이지 않는다.
5. 포함률과 함께 폭, 빗나간 크기, 실제 행동을 기록한다
구간을 아주 넓히면 더 많은 결과를 담을 수 있지만 판단에 보태는 정보는 줄어든다. 포함률만 높인 모형과 같은 포함률에서 더 유용한 폭을 제시하는 모형을 구분해야 한다.
앞의 계산처럼 구간이 예측값 기준으로 좌우 대칭이어도, 위쪽·아래쪽으로 벗어날 확률이 각각 5%라는 보장은 없다.
구간 밖의 결과도 한 번으로만 세지 않는다. 하단을 0.1%p 벗어난 경우와 10%p 벗어난 경우의 계좌 영향은 다르다. 예측구간에는 거래 비중·비용·청산 가격이 들어 있지 않으므로 하단을 계좌의 손실 한도로 표시할 수 없다.
적용할 때는 다음을 함께 남긴다.
대상은 평균인가, 다음 개별 관측인가. 예측 기간과 단위는 무엇인가.
학습·보정·최종 평가 자료는 어떻게 나눴고, 미래 정보는 빠졌는가.
어떤 상황에서 포함률이 낮았으며 그 상황의 표본은 몇 개인가.
구간 폭과 하단을 벗어난 크기는 시간에 따라 어떻게 변했는가.
구간을 보고 바꾼 행동이 비용과 실제 손익까지 개선했는가.
예측구간의 가치는 90%라는 이름보다, 어느 조건에서 얼마나 유용한 범위를 제공했는지에 있다. 그 조건을 기록해야 다음의 구간을 어떤 판단에 쓸 수 있을지도 보인다.