
AI가 투자자의 전망보다 정확했다는 연구, AI 거래자가 담합과 비슷한 행동을 학습했다는 연구, AI 펀드의 성과 우위가 줄었다는 연구를 함께 읽으면 결론이 충돌하는 것처럼 보인다.
그러나 AI라는 이름만 같을 뿐 알고리즘과 시장 환경, 측정한 결과가 다를 수 있다. 연구를 투자 판단에 활용하려면 무엇을 시험한 근거인지 먼저 구분해야 한다.
AI가 무엇을 잘하거나 못한다는 결론에는 사용한 알고리즘·입력·환경·비교 대상이 필요하다. 다른 연구의 결과를 같은 실험의 성적처럼 합치지 않는다.
1. AI가 맡은 역할을 구체적으로 적는다
AI로 뉴스 초안을 만드는 것, 미래 값을 예측하는 것, 반복적인 거래에서 행동을 학습하는 것, 기존 매매 규칙의 코드를 만드는 것은 다른 역할이다. 같은 모델 이름을 사용해도 맡긴 작업과 실행 권한은 다를 수 있다.
어떤 입력에서 무엇을 출력하고, 무엇을 최적화하며, 행동이 다시 학습 자료에 영향을 주는지 적는다. 사람이 검토하는 분석 보조와 실제 포지션을 변경하는 운용도 나누어 본다.
AI 사용 여부보다 성과에 연결되는 경로를 확인한다. 코드 작성 속도가 좋아졌다는 결과를 예측력이나 비용 후 운용 성과의 증거로 옮기지 않는다.
2. 시뮬레이션·예측 평가·펀드 관측의 질문을 나눈다
NBER에 공개된 세 연구의 초록은 서로 다른 대상을 설명한다.
연구 | 초록에서 설명한 대상 | 그대로 확대하지 않을 판단 |
|---|---|---|
AI-Powered Trading, Algorithmic Collusion, and Price Efficiency, 2025년 7월 | 정보 보유 거래자의 이론모형과 강화학습 거래자 시뮬레이션 | 실제 모든 AI 거래자가 같은 행동을 한다 |
The Prestakes of Stock Market Investing, 2025년 10월 | 머신러닝 기대 형성과 시장 참여자의 주관적 전망 비교 | 현재 어떤 모델도 사람보다 높은 거래 수익을 낸다 |
The Growth and Performance of Artificial Intelligence in Asset Management, 2026년 5월 | 공시·채용·전략 설명으로 분류한 AI 운용과 펀드 성과 | AI라는 표기만으로 내 전략의 효과가 확인됐다 |
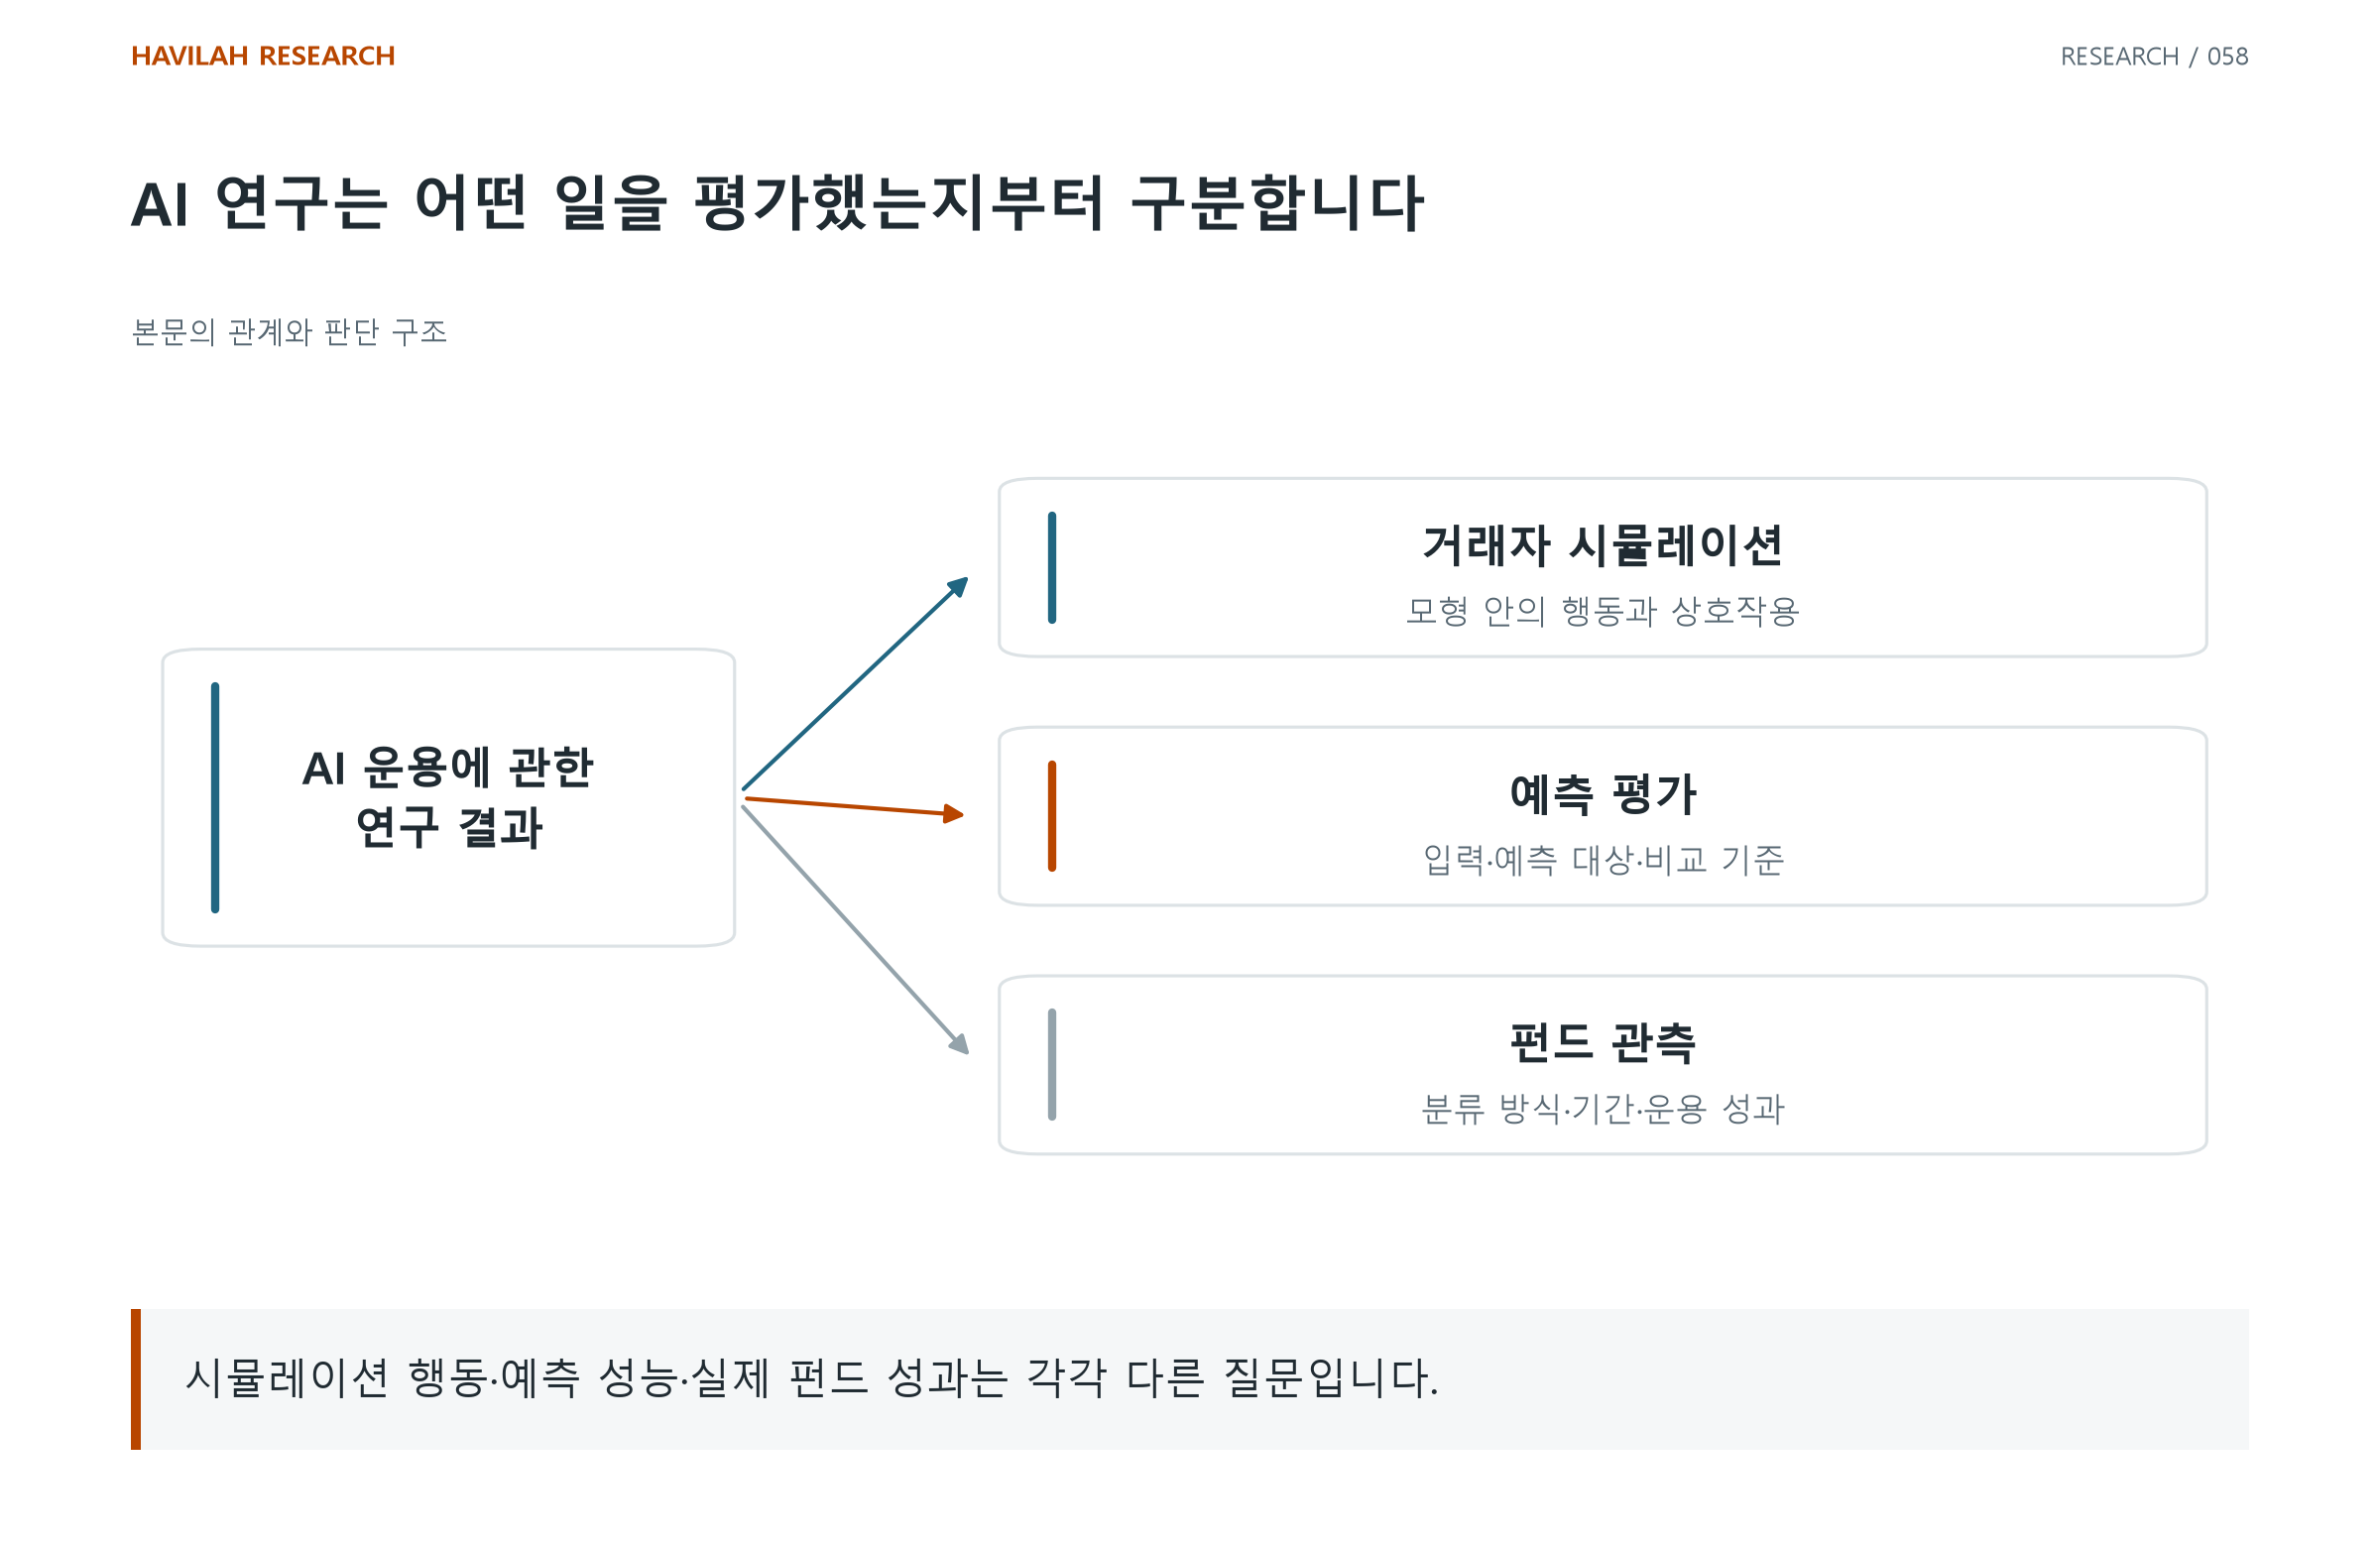
이 구분은 연구를 서열화하는 방법이 아니다. 각 근거가 답하는 질문과 우리 판단 사이의 거리를 확인하는 방법이다. 본문에 쓰인 자료·가정·검정과 현재 사용할 조건은 추가로 읽어야 한다.
3. 다른 환경의 결과는 함께 성립할 수 있다
첫 연구는 설정한 모형의 강화학습 거래자들이 명시적인 합의·의사소통 없이 경쟁 수준을 넘는 이익을 유지한 결과를 보고한다. 이는 시뮬레이션에서 상호작용을 살펴본 연구이며 실제 시장 사건에 대한 법적 판정은 아니다.
세 번째 연구는 분류된 AI 헤지펀드의 수익률 동조성이 비AI 펀드보다 낮았다고 보고한다. 이 관측이 첫 모형의 가능성을 부정하거나 모든 시장의 군집 위험을 없애지는 않는다.
특정 조건에서 같은 행동을 학습할 수 있다는 결과와, 다른 표본에서 수익률이 덜 비슷했다는 결과는 같은 명제가 아니다. 모형의 참가자·학습 방식과 실제 펀드의 정의·자료를 맞춰 읽는다.
4. 더 나은 예측과 더 나은 거래를 별도로 평가한다
전망의 정확도와 포지션의 손익은 다르다. 예측 대상·시간 간격·오차 기준을 정하고, 그 예측을 언제 어떤 가격으로 거래할 수 있었는지 확인해야 한다.
펀드 성과 비교에서도 기간·벤치마크·위험 노출·비용과 표본 구성을 살핀다. AI 사용을 분류한 시점과 자료가 당시 실제로 이용 가능했는지도 중요하다. 관측된 차이의 존재와 AI 도입이 그 차이를 만들었다는 인과는 따로 평가한다.
연구의 역사적 결과를 현재 상품의 예상 수익으로 바꾸거나, 보고한 초과성과가 앞으로도 유지된다고 가정하지 않는다.
5. 연구에서 가져올 것과 새로 확인할 것을 남긴다
연구별로 질문·알고리즘·환경·자료 기간·비교 기준·주요 결과와 한계를 한 줄씩 적는다. 초록만 확인했다면 본문의 실험 설정과 비용·표본 처리를 확인한 것처럼 기록하지 않는다.
우리 작업에 적용하려면 같은 역할의 단순한 기준과 비교하고, 선택에 쓰지 않은 자료·실행 조건에서 결과를 확인한다. 상호작용을 다루는 가설이라면 경쟁자와 시장의 반응을 고정한 평가가 무엇을 놓치는지도 살핀다.
유용한 연구 읽기는 결론을 복사하는 일보다, 다음에 확인할 가정과 비교를 구체화하는 일에 가깝다.
적용할 때는 ‘이 연구의 AI는 무슨 역할을 하는가?’, ‘모형과 관측 자료 중 어떤 근거인가?’, ‘내 판단에 적용하려면 무엇을 추가로 검증해야 하는가?’를 확인한다.