
같은 AI 모델에 질문해도 짧은 문장 하나를 넣을 때와 문서 수십 개를 넣을 때 서버의 부담은 달라진다. 모델 파일의 크기가 그대로인데도 동시에 받을 수 있는 요청 수가 줄어드는 이유가 있다.
서버는 모델을 저장하는 공간 외에, 각 요청의 앞부분을 이어서 계산하기 위한 공간도 필요하다. 긴 문맥을 제공하는 서비스의 비용을 읽으려면 이 두 공간을 나누어 봐야 한다.
긴 문맥의 비용은 입력을 읽는 계산량과, 답변을 이어 가기 위해 점유하는 메모리에서 함께 생긴다.
1. 모델의 기억과 지금 대화의 상태를 구분한다
모델의 가중치는 학습을 통해 정해진 숫자들이다. 같은 모델을 쓰는 요청들이 이를 함께 사용할 수 있다. 반면 KV 캐시는 각 요청의 앞선 토큰에서 계산한 키와 값 벡터를 보관하는 공간이다. 다음 토큰을 만들 때 이전 부분을 활용하기 위해 필요하다.
PagedAttention 논문의 2~3절은 이 구조와 요청별 메모리 문제를 설명한다. 모델 가중치는 비교적 고정되어 있지만, 요청의 입력과 출력이 길어질수록 KV 캐시는 커질 수 있다.
이 캐시는 계정의 대화 기록을 영구 보관하는 데이터베이스와도 다르다. 보통 요청 처리와 관련된 계산 상태이며, 서비스의 캐시 정책에 따라 재사용하거나 해제할 수 있다. 긴 대화를 처리할 수 있다는 기능과 과거 대화를 저장한다는 기능을 같은 비용으로 읽지 않는다.
2. 토큰 한 개의 메모리부터 계산해 본다
모든 토큰의 KV 상태를 저장하는 일반적인 구조를 가정하자. 한 요청의 KV 메모리는 대략 ‘키와 값 두 벌 × 층 수 × KV 헤드 수 × 헤드 차원 × 토큰 수 × 원소당 바이트’로 계산할 수 있다.
가상의 모델이 32개 층, KV 헤드 8개, 헤드 차원 128, 원소당 2바이트를 사용한다면 토큰 한 개당 131,072바이트, 즉 128KiB다. KiB는 1,024바이트, GiB는 1,024의 세제곱 바이트를 뜻한다. 다른 작업 공간과 메모리 관리 비용은 제외했다.
한 요청의 전체 문맥 길이 | KV 캐시 계산값 |
|---|---|
8,192토큰 | 1GiB |
32,768토큰 | 4GiB |
65,536토큰 | 8GiB |
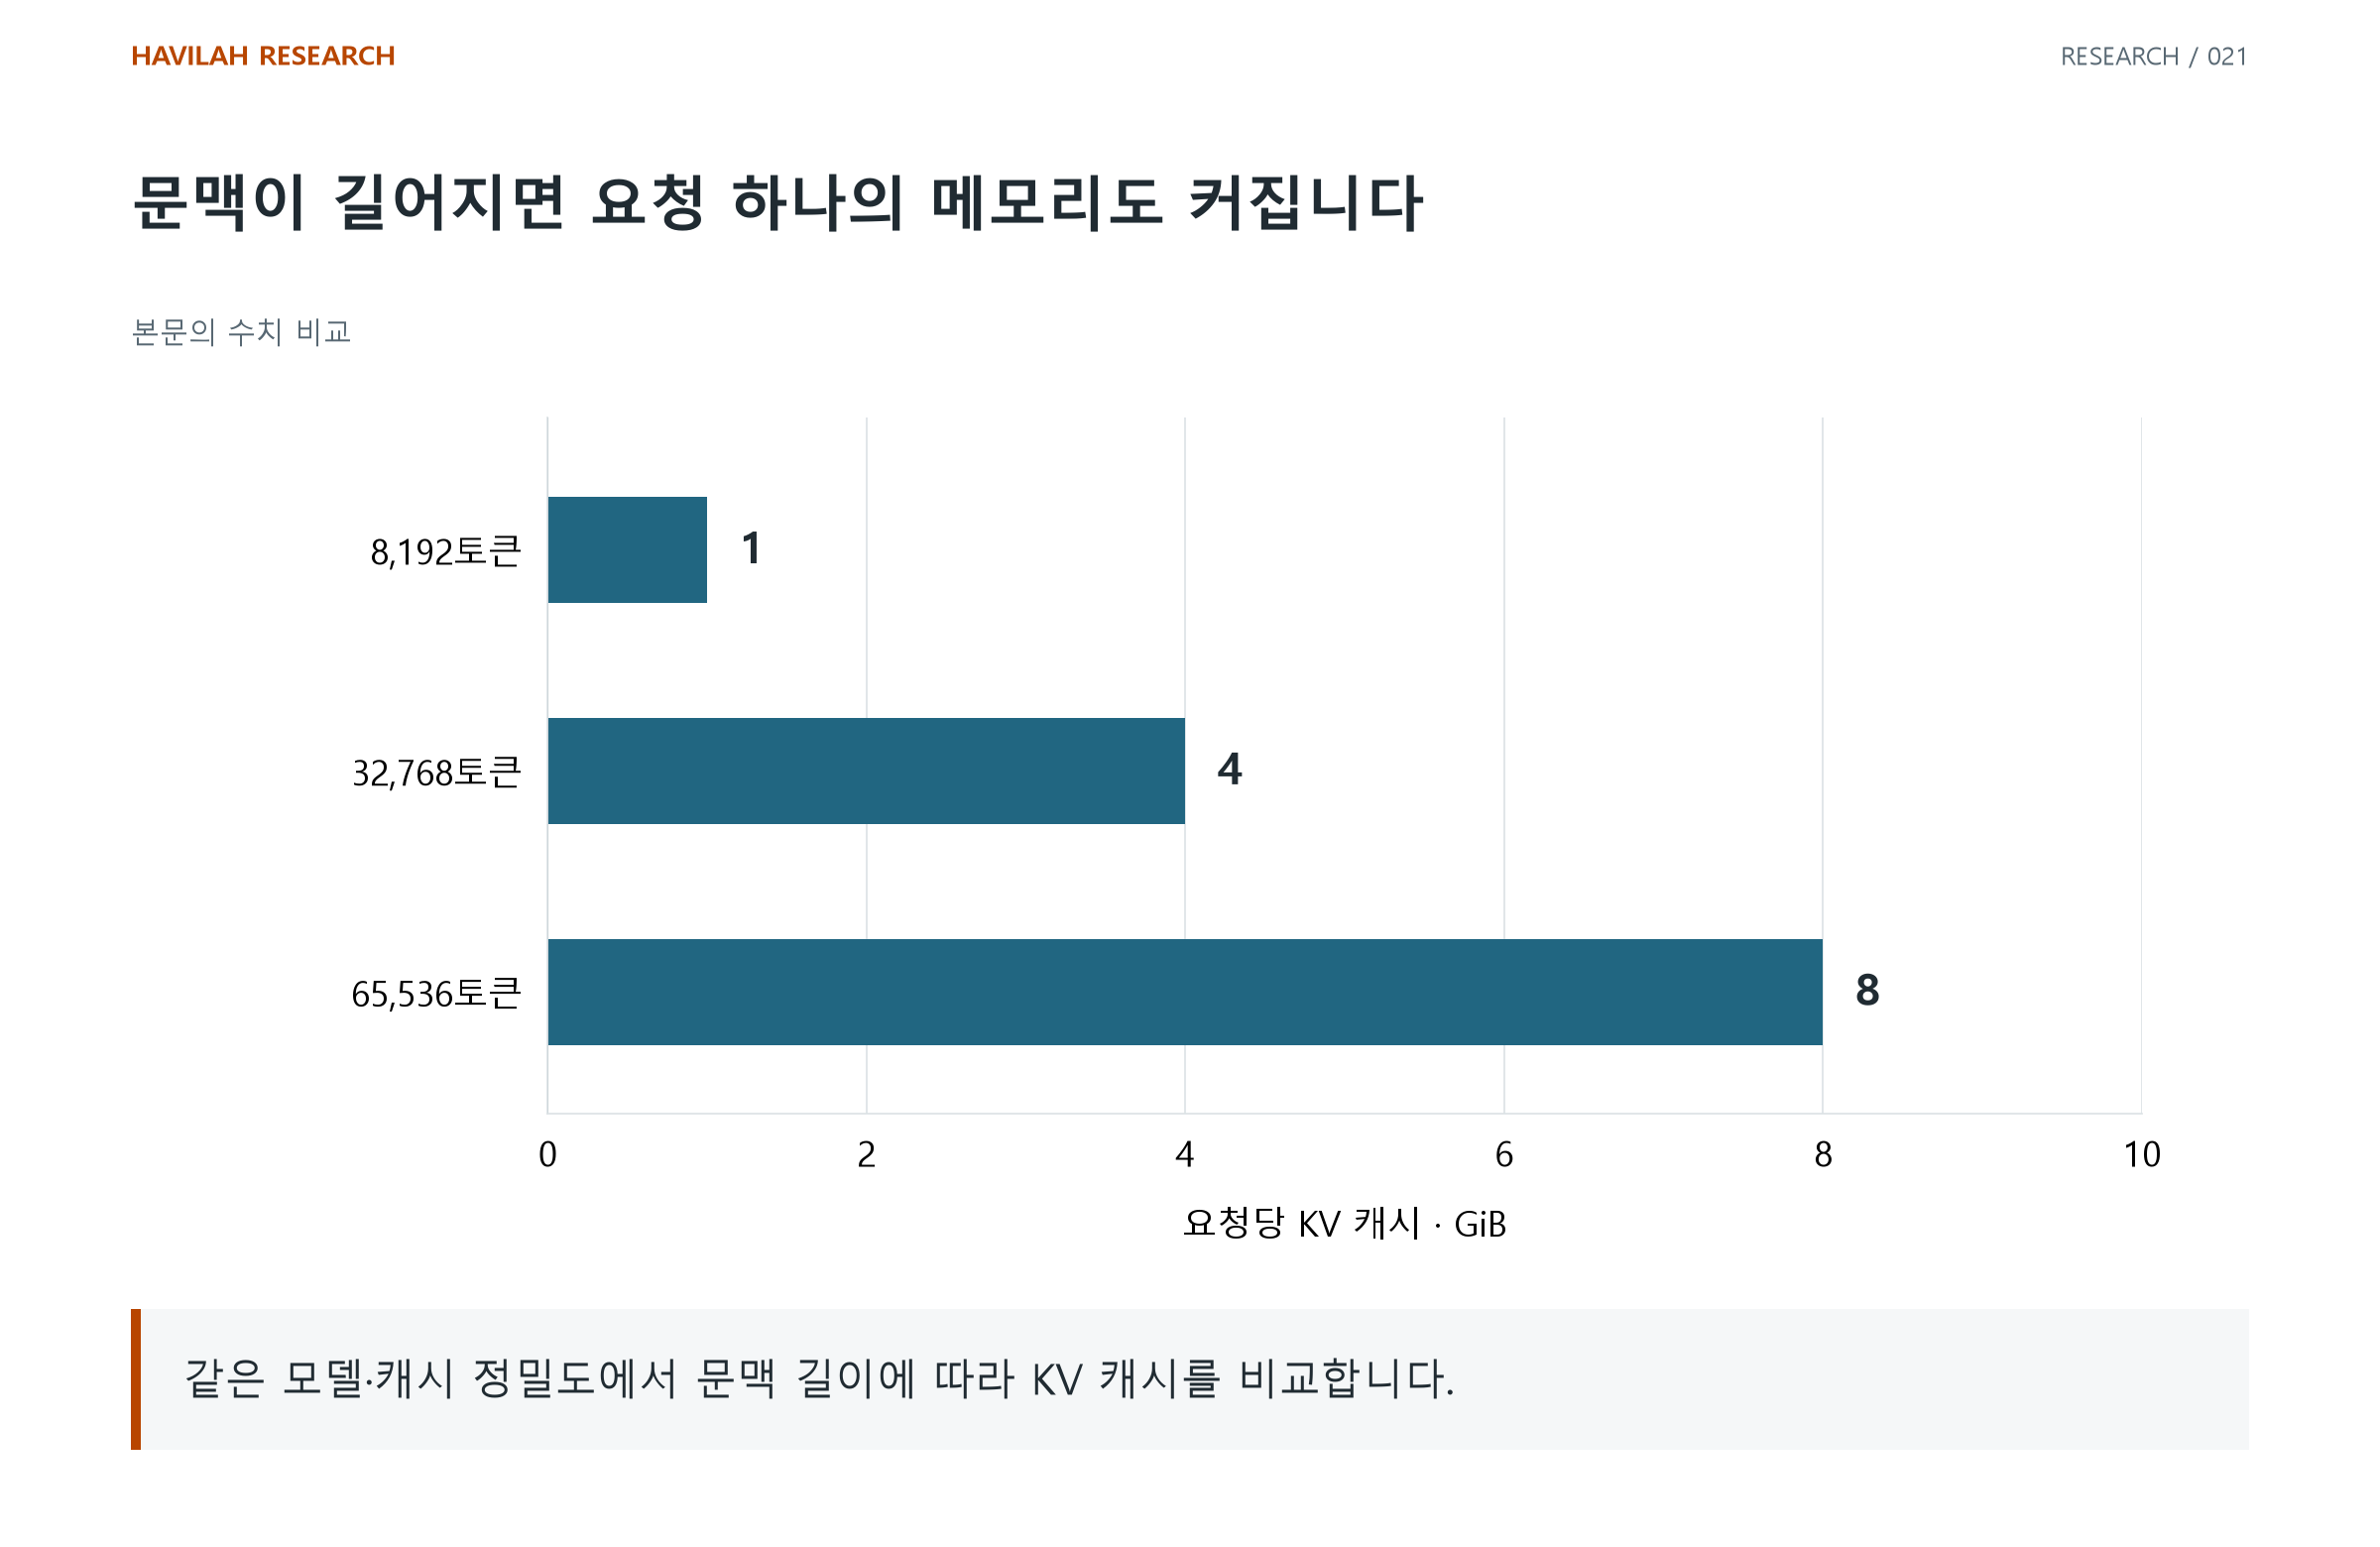
여기서 문맥은 입력만이 아니라 생성하면서 저장되는 출력까지 포함한다. 또한 이 산식은 모든 모델에 그대로 적용되지 않는다. KV 헤드 공유, 캐시 압축, 슬라이딩 윈도와 다른 어텐션 구조를 사용하면 저장 범위나 크기가 바뀐다.
중요한 점은 특정 모델의 소비량을 맞히는 것이 아니다. 지원하는 최대 문맥 길이가 네 배라고 해서, 같은 서버에서 네 배 긴 요청을 같은 수만큼 처리할 수 있는 것은 아니다.
3. 요청 하나의 메모리가 동시 처리 수를 바꾼다
가중치와 다른 필수 공간을 뺀 뒤 KV 캐시에 쓸 수 있는 메모리가 32GiB라고 하자. 위 예시의 1GiB 요청은 산술적으로 최대 32개, 4GiB 요청은 최대 8개가 들어간다. 이는 메모리만 고려한 상한이며, 실제 처리 능력을 뜻하지 않는다.
계산 속도, 메모리 대역폭과 응답시간 조건 때문에 상한에 도달하기 전부터 제약이 생길 수 있다. 그럼에도 요청의 길이가 같은 장비에서 동시에 수용할 수 있는 요청 수를 바꾼다는 관계는 보인다.
길이가 계속 늘어나는 답변은 요청을 오래 점유하기도 한다. 따라서 최대 문맥 길이만 공개된 서비스와 실제 고객들의 입력·출력 길이 분포까지 공개된 서비스는 수익성을 추정할 수 있는 정보의 범위가 다르다.
4. 캐시는 낭비를 줄일 수 있지만 문맥을 공짜로 만들지는 않는다
PagedAttention은 KV 상태를 작은 블록으로 관리해, 사용하지 않을 최대 길이만큼 미리 잡아 두는 낭비를 줄인다. 같은 접두 부분을 공유하는 요청에서는 계산과 저장을 재사용할 여지도 있다.
vLLM의 접두 캐시 설명은 같은 앞부분의 재계산을 줄이는 이점과, 새 답변을 생성하는 단계 자체의 시간을 줄이지는 않는 한계를 함께 설명한다. 동일한 문서를 반복 질문하는 업무와 매번 새로운 긴 문서를 읽는 업무는 캐시 활용도가 다를 수 있다.
반대로 캐시를 보관하는 동안에는 메모리를 점유한다. 재사용 가능성이 낮은 상태를 오래 남겨 두면 다른 요청을 받을 공간이 줄 수 있다. ‘캐시 적중률이 높다’는 숫자에도 절약한 계산량과 차지한 메모리, 요청 길이를 함께 붙여야 한다.
5. 긴 문맥의 가치를 고객의 업무에서 확인한다
긴 문맥은 여러 문서의 관계를 함께 확인해야 할 때 유용하다. 하지만 같은 정확도를 필요한 문단만 검색해 넣는 방식으로 얻을 수 있다면 비용 구조가 달라진다. 문맥을 줄이는 대신 검색 실패나 누락이 늘어날 수도 있으므로 품질을 함께 비교해야 한다.
투자 관점에서는 긴 문맥의 제공 여부보다, 이를 필요로 하는 고객이 얼마나 있고 얼마를 지불하는지가 중요하다. 고객에게 필요한 문맥을 응답시간과 품질 조건 안에서 제공하는 비용이 서버와 서비스 사업의 연결 고리다.
가격표와 성능표에 입력·출력 길이와 동시 요청 수가 함께 있는가?
고객의 문서는 얼마나 반복되며, 실제로 재사용할 수 있는 앞부분이 있는가?
메모리 절약이 더 많은 유료 요청으로 이어졌는가, 다른 병목이 남았는가?
짧은 문맥과 검색을 조합한 대안보다 품질이나 비용에서 어떤 이점이 있는가?