
큰 커뮤니티와 자료 보관함을 보면 AI 시대에 중요한 자산이라고 생각하기 쉽다. 하지만 데이터가 많다는 사실만으로 고객의 문제를 해결하거나 반복적인 수익을 만들 수 있는지는 알 수 없다.
데이터의 가치는 내용과 이용 조건, 전달 방식과 유지 비용을 함께 보아야 한다. 소유·수집의 규모에서 실제 고객의 기여까지 연결하는 과정이다.
데이터 사업은 얼마나 모았는가와 고객의 어떤 결과를 얼마나 개선하는가를 나누어 평가한다.
1. 데이터가 쓰일 업무를 구체적으로 정한다
과거 지식의 학습과 현재 정보의 검색, 특정 소비자 조사와 결과 평가에는 다른 자료가 필요할 수 있다. 많은 데이터가 모든 용도에 똑같이 유용하다고 두지 않는다.
자료를 추가한 경우와 추가하지 않은 경우를 같은 업무·평가 기준에서 비교한다. 필요한 정확도와 최신성, 드문 실패를 얼마나 개선하는지 확인해야 고객 가치의 근거가 된다.
2. 품질의 설명에 수집 범위와 빈칸을 포함한다
누가 어떤 상황에서 만든 자료인지, 중복과 누락·선택 편향이 있는지 본다. 실제 경험에서 나온 내용도 모든 사람의 경험을 대표하거나 사실이 확인된 답이라는 뜻은 아니다.
《Datasheets for Datasets》는 데이터의 목적·구성·수집·사용과 유지에 관한 문서화를 제안한다. 그런 설명은 이용자가 적합성과 한계를 판단할 근거이며 데이터 자체의 정확성을 자동 보증하지는 않는다.
3. 접근 권한과 판매 가능한 권리를 구분한다
자료를 열람하거나 보관할 수 있다는 사실과 특정 목적으로 외부 고객에게 제공할 수 있다는 권리는 다르다. 적용 계약과 동의·이용 범위를 실제 문서에서 확인한다.
학습·검색·재배포·상업 이용과 갱신의 조건이 다를 수 있다. 데이터 사업의 매출 가정에는 고객에게 약속할 수 있는 실제 제공 범위가 들어가야 한다. 공개 게시물이라는 이유만으로 모든 권리가 해결되었다고 가정하지 않는다.
4. 갱신과 정리 비용을 수익 구조에 넣는다
한 번 모은 자료를 파는 것과 계속 최신 자료를 전달하는 사업은 비용이 다르다. 수집·정리·오류 수정·분류와 안정적인 전달에 필요한 자원을 확인한다.
신선한 자료가 중요한 업무라면 과거 데이터의 규모만으로 갱신 능력을 평가할 수 없다. 반대로 매번 새 자료를 만드는 데 많은 비용이 든다면 반복 매출이 늘어도 남는 현금은 따로 확인해야 한다.
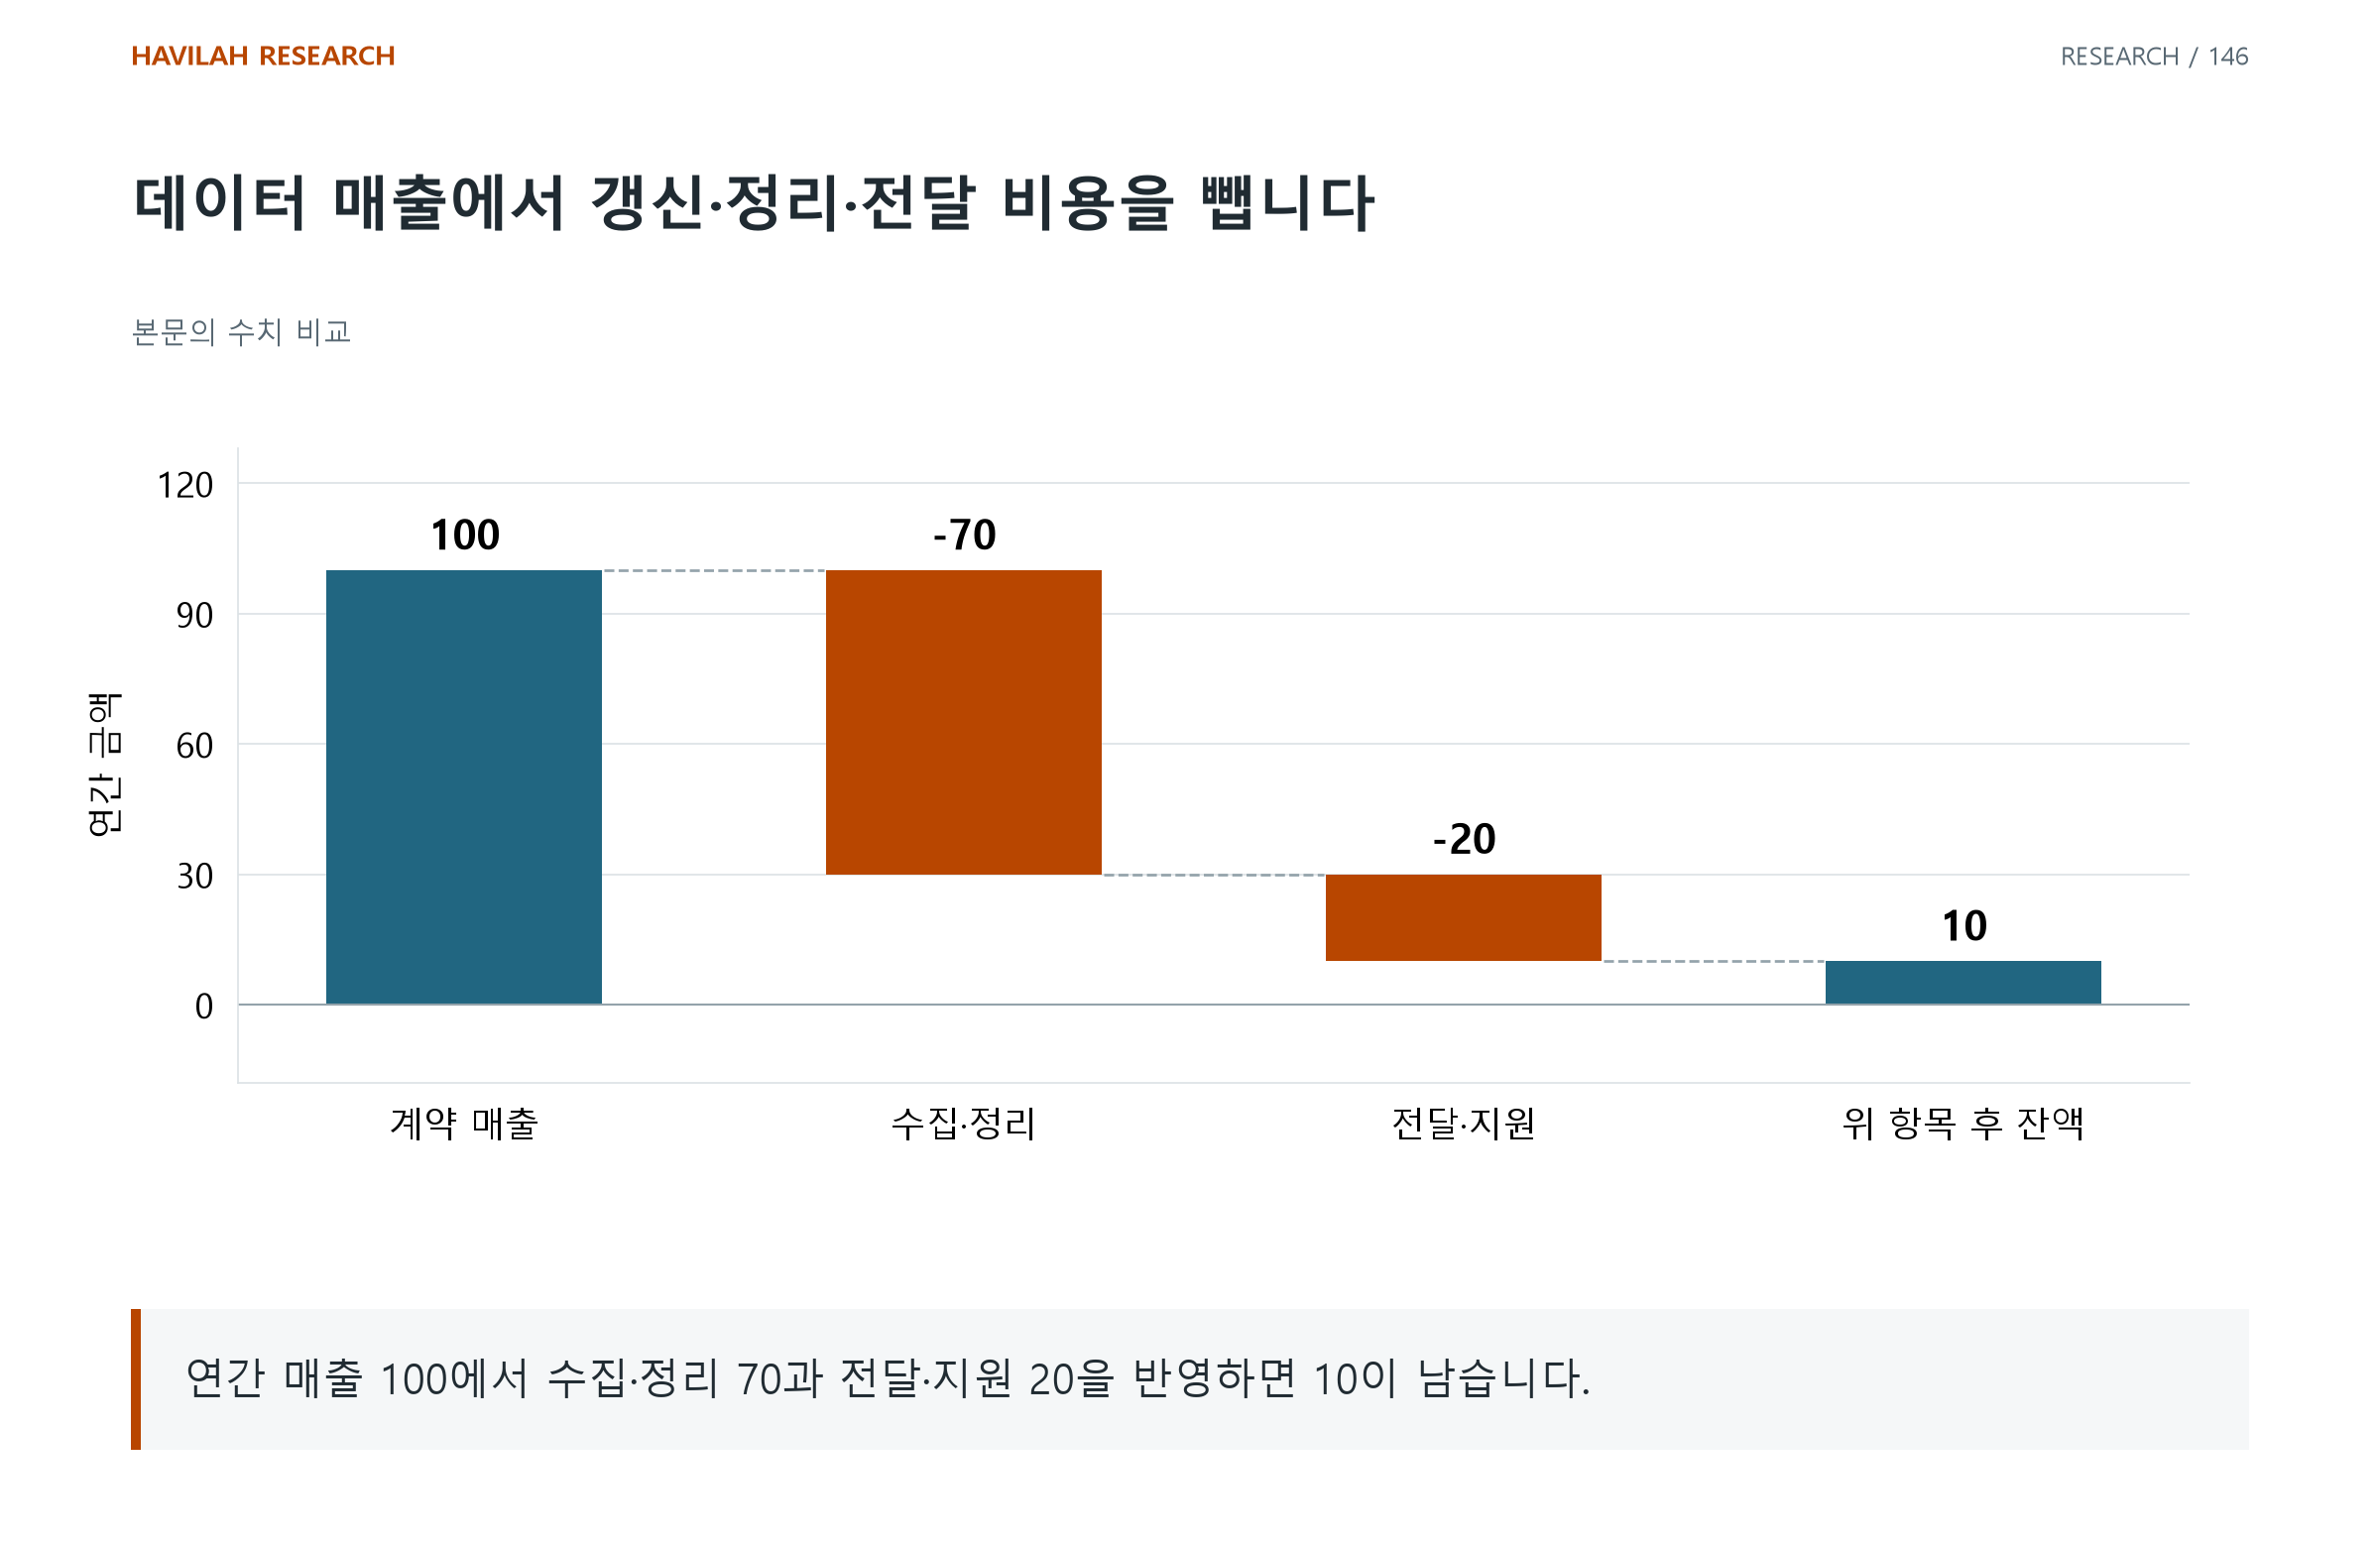
가상으로 연간 데이터 계약 매출이 100이고 수집·정리에 70, 고객별 전달·지원에 20이 든다면 이 항목들 뒤에 남는 금액은 10이다. 여기에 빠진 일반관리비·세금·투자 지출도 확인해야 한다. 계약이 늘 때 같은 데이터를 재사용할 수 있는지, 고객마다 비용을 다시 써야 하는지에 따라 규모 확대의 효과가 달라진다.
5. 계약과 경쟁 우위를 각각 검토한다
고객이 데이터를 쓰는 사실, 실제 대금을 지급하는 사실, 다음 계약에서도 선택할 이유를 나눈다. 대체 자료와 직접 수집의 비용, 데이터가 없을 때 잃는 기여를 비교한다.
가격과 계약 기간, 고객 집중과 비용을 함께 읽는다. 데이터의 희소성은 중요한 단서지만 그 희소성이 고객의 결과와 사업자의 현금으로 이어져야 경제적 가치가 드러난다. 주식 투자에는 다시 현재 가격과 주주에게 돌아올 몫을 연결한다.
적용해 볼 질문
이 자료가 어떤 고객 업무의 결과를 실제로 개선하는가?
제공할 수 있는 권리와 수집·평가의 한계를 확인했는가?
갱신·정리·전달 비용과 다음 계약의 선택 이유를 함께 보았는가?