
AI 학습을 하루 돌렸는데 장애로 마지막 세 시간을 다시 계산해야 한다면, 그 세 시간의 GPU 사용은 완료된 학습 진도로 남지 않는다. 중간 결과를 자주 저장하면 손실을 줄일 수 있지만 저장 때문에 계산이 멈추기도 한다.
서버의 처리 속도만 비교하면 이 교환을 놓친다. 같은 장비라도 저장과 복구의 방식에 따라 모델을 완성하는 데 필요한 시간이 달라진다.
학습 비용은 계산 속도에 더해, 저장에 쓰는 시간과 장애 뒤 다시 계산하는 시간으로 결정된다.
1. 파일이 있어도 학습을 이어 갈 수 있는지는 다르다
체크포인트는 장애 뒤 돌아갈 학습 상태다. 모델 가중치를 보관하면 예측에 사용할 수 있지만, 같은 학습을 이어 가려면 학습률과 갱신 이력을 관리하는 옵티마이저 상태도 필요할 수 있다.
PyTorch의 저장·복원 문서는 학습 재개용 저장에서 모델과 옵티마이저의 상태, 학습 진행 위치 등을 함께 다룬다. 정확한 재개를 원하면 데이터의 읽은 위치, 난수와 학습률 조정 상태 등도 자신의 학습 구성에 맞게 확인해야 한다.
저장 완료의 기준은 파일 생성이 아니라 필요한 상태를 실제로 읽어 재개할 수 있는가다. 여기서 다루는 저장은 장애 복구용이다. 메모리를 아끼기 위해 중간 계산을 다시 수행하는 활성값 체크포인팅과는 목적이 다르다.
2. 저장 간격은 두 종류의 시간 낭비를 바꾼다
가상 학습 작업을 생각해 보자. 복원 가능한 상태를 저장할 때 계산이 2분 멈추고, 작업 전체를 중단시키는 장애가 평균 20시간에 한 번 발생한다고 가정한다. 장비의 실제 고장률을 추정한 수치는 아니다.
저장 사이의 유효 계산 간격을 T분, 한 번의 저장 중단을 C분, 작업의 평균 장애 간격을 M분이라고 쓰자. 자주 저장하면 유효 계산시간에 대한 저장 부담 C/T가 커진다.
장애가 일정한 비율로 독립적으로 발생하고 간격이 충분히 짧다면, 장애 한 번에 다시 계산할 분량은 대략 T/2다. 이를 장애 간격으로 나누면 재계산 부담은 대략 T/(2M)가 된다. 두 부담을 더한 1차 근사는 다음과 같다.
시간 손실 부담 ≈ C/T + T/(2M)
이 비율은 유효 계산시간에 대한 근사 부담이며, 실제 전체 운전시간의 정확한 손실률이 아니다. 저장 시간이 계산 간격에 비해 작고, 장애 간격이 더 긴 경우의 비교용 계산이다. 복구 준비, 저장 도중 장애와 저장소 경합은 별도로 측정해야 한다.
유효 계산 간격 T | 저장 부담 C/T | 재계산 부담 T/(2M) | 근사 합계 |
|---|---|---|---|
30분 | 6.67% | 1.25% | 7.92% |
60분 | 3.33% | 2.50% | 5.83% |
120분 | 1.67% | 5.00% | 6.67% |
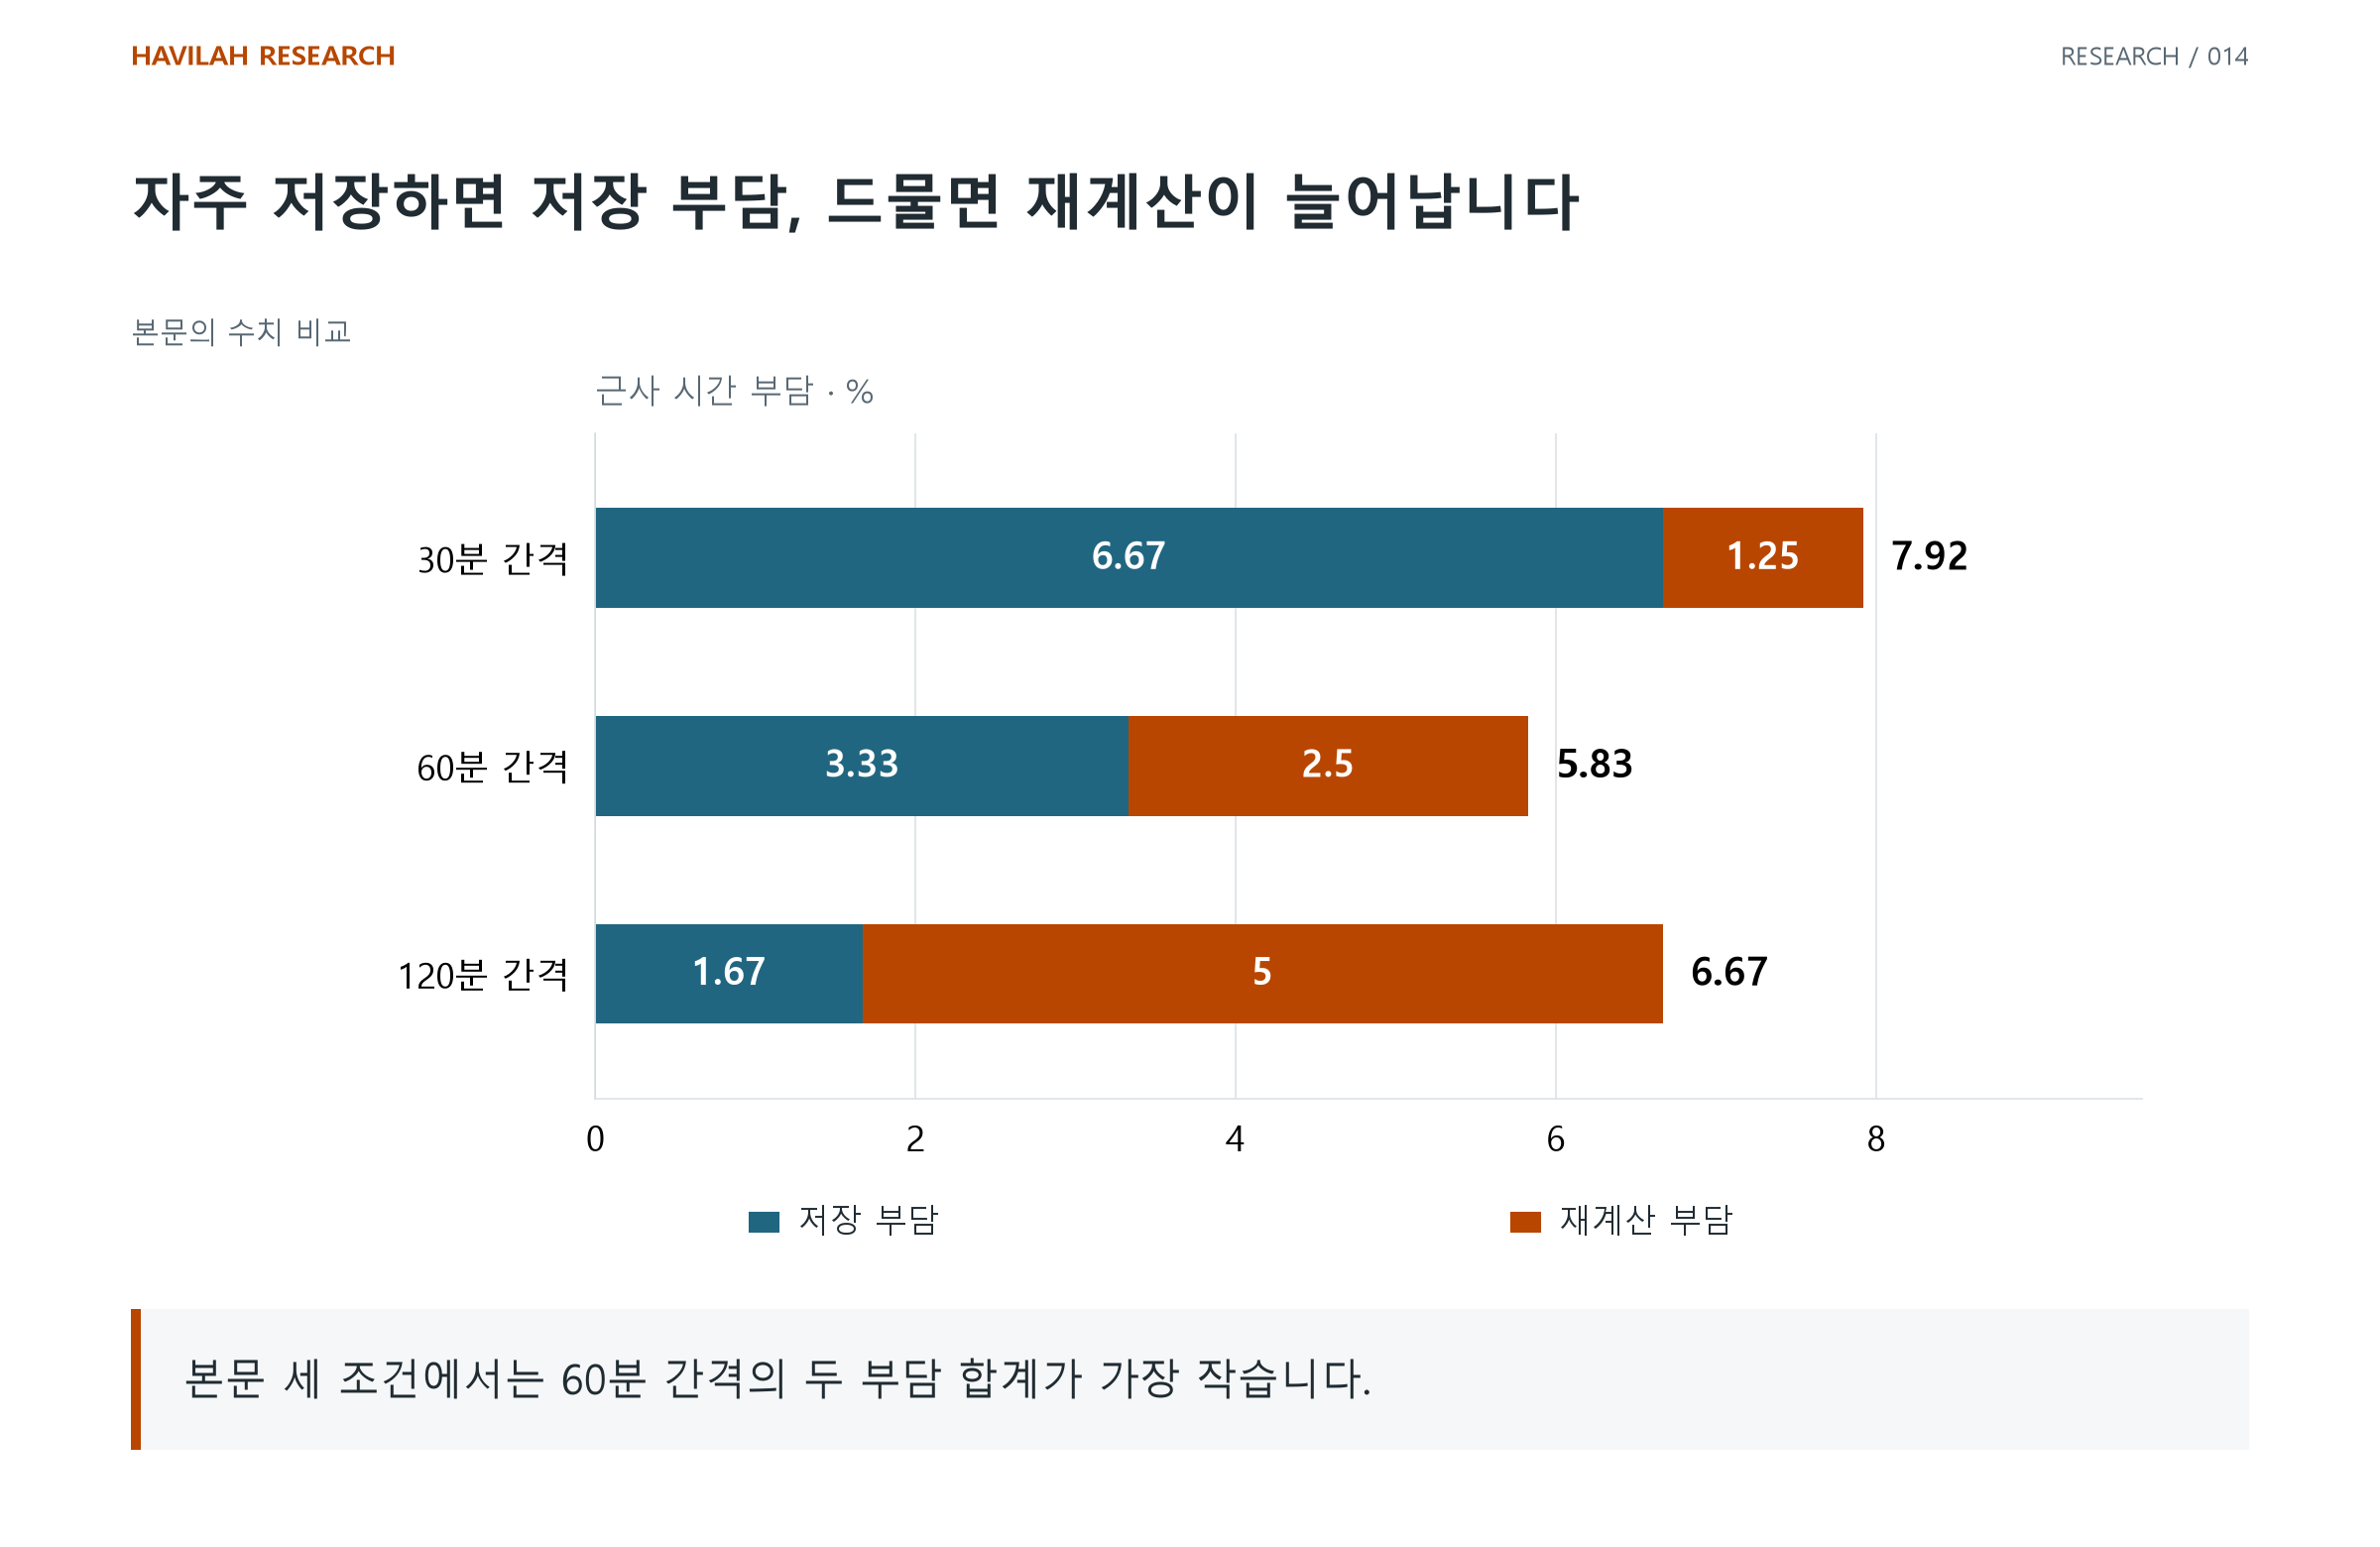
매번 빨리 저장하는 것이 항상 유리하지도, 가능한 한 오래 계산하는 것이 항상 유리하지도 않다. 저장 부담과 재계산 부담이 서로 반대 방향으로 움직이기 때문이다.
3. 저장이 싸지면 더 자주 저장할 이유가 생긴다
위 근사식이 가장 작아지는 간격은 √(2CM)이다. C=2분, M=1,200분이면 약 69.3분이다. 두 손실 항목이 같아지는 지점이기도 하다. 이 결과는 미국 DOE의 장애 관리 보고서의 체크포인트 1차 근사와 같은 구조다.
저장 중단을 2분에서 0.5분으로 줄이고 다른 조건을 유지하면 간격은 약 34.6분이 된다. 최저 근사 부담도 약 5.77%에서 2.89%로 줄어든다. 저장 개선은 한 번의 중단만 줄이는 것이 아니라, 잃어버릴 학습 분량을 더 자주 고정할 여유를 만든다.
다만 비동기 저장을 시작했다고 C가 0이 되는 것은 아니다. 계산과 동시에 쓰는 과정이 메모리·통신·저장소를 사용해 학습을 느리게 할 수 있다. 복원이 가능한 저장 시점과 장벽, 실제 학습 지연을 함께 재야 한다.
Daly의 연구는 단순한 1차 모형과 더 정교한 모형을 구분한다. 위의 69.3분을 모든 AI 학습에 적용할 운영 규칙으로 받아들이면 안 된다.
4. 서버 한 대의 신뢰도를 전체 작업에 그대로 쓰지 않는다
분산 학습에서는 서버 한 대의 장애가 전체 작업을 멈출 수도 있다. 이 경우 필요한 M은 개별 서버가 아니라 작업 전체의 중단 간격이다.
가상으로 각 노드의 장애가 독립적인 일정 비율로 발생하고, 어느 한 대의 장애든 작업을 멈춘다고 가정하자. 노드 한 대의 평균 장애 간격이 2,560시간이면 128대 작업의 평균 간격은 20시간이다. 256대에서는 10시간이 된다.
이 가정 아래에서는 대수를 두 배로 늘릴 때 같은 저장 비용에서 부담이 최소인 근사 간격이 약 69.3분에서 49.0분으로 짧아진다. 실제 장비의 장애 수치가 아니라 확장하면 작업의 장애 노출도 함께 늘 수 있다는 계산이다.
공통 전원 장애처럼 서로 연결된 고장이나, 일부 노드만 복구하며 계속 계산하는 구조에서는 이 나눗셈이 맞지 않는다. 작업 중단 로그와 재개 기록이 있어야 서버 확대의 경제성을 계산할 수 있다.
5. 완료한 학습 진도를 기준으로 비교한다
먼저 한 번 저장할 때 실제 학습이 얼마나 지연되는지 측정한다. 다음으로 최근 저장본을 다른 작업에서 복원해, 누락된 상태 없이 진도를 이어 갈 수 있는지 확인한다. 저장 주기의 기준값에는 노드 고장률 대신 전체 작업의 중단 기록을 넣는다.
장애 뒤 재할당·다운로드·재시작까지 걸린 시간도 따로 더한다. 학습 시간이 짧거나 장애가 특정 구간에 몰리는 작업이라면 일정 간격의 장기 평균 모형보다 종료 시한과 실패 양상을 직접 반영해야 한다.
AI 인프라의 성능은 초당 계산량뿐 아니라, 정해진 비용과 시간 안에 완료한 학습 진도로 비교할 수 있다. 저장소와 복구 설계가 GPU 증설만큼 중요한 조건이 되는 이유다.