
AI 서버가 초당 더 많은 토큰을 생성한다는 성능표는 설득력 있어 보인다. 그러나 사용자가 한참 기다려야 하거나, 답변이 나오다가 자주 끊긴다면 그 처리량을 그대로 판매 능력이라고 보기는 어렵다.
서버 사업의 경제성에서 필요한 숫자는 고객에게 약속한 시간을 지키며 처리할 수 있는 양이다. 최대 속도와 이 양의 차이를 알아야 성능 개선이 매출과 비용에 어떻게 연결되는지 읽을 수 있다.
AI 서버의 판매 능력은 최대 토큰 처리량보다, 고객의 응답시간 조건을 만족하는 요청을 얼마나 처리했는지에 달려 있다.
1. 첫 답변을 기다리는 시간과 답변이 이어지는 속도를 나눈다
첫 토큰까지 걸리는 시간인 TTFT는 질문을 보낸 뒤 첫 반응을 기다리는 시간이다. 이후 토큰당 시간인 TPOT는 답변이 얼마나 빠르게 이어지는지를 나타낸다. 첫 반응은 빨라도 긴 답변이 느릴 수 있고, 전체 생성량은 많아도 첫 반응이 늦을 수 있다.
MLCommons의 Llama 3.1-8B 벤치마크 설명도 두 시간을 따로 평가한다. 대화형 시나리오에는 일반 서버 시나리오보다 더 엄격한 시간 조건을 둔다. 같은 하드웨어도 어떤 업무를 가정했는지에 따라 평가가 달라지는 것이다.
성능표의 초당 토큰이 입력을 읽은 양인지, 새로 생성한 출력인지도 확인해야 한다. 문서 요약과 짧은 채팅은 두 양의 비율부터 다르다. 토큰의 종류와 시간 조건이 빠진 속도 비교는 고객의 사용 경험을 설명하지 못한다.
2. 많이 묶어 처리하면 한 사람의 기다림은 늘 수 있다
여러 요청을 함께 계산하는 배치는 장비 활용에 도움이 될 수 있다. 하지만 요청을 모으기 위해 기다리거나 긴 요청 때문에 짧은 요청이 밀리면 처리량과 응답시간의 방향이 달라진다.
이를 보여 주는 가상의 한 시간 실험을 보자. 양쪽 모두 같은 모델과 같은 요청 목록을 사용하고, 요청마다 출력은 정확히 100토큰이다. A는 작은 배치, B는 큰 배치를 사용한다.
실험 결과 | A | B |
|---|---|---|
전체 처리 요청 | 6,000건 | 9,000건 |
두 가지 응답시간 조건을 모두 지킨 요청 | 5,700건 | 4,500건 |
조건을 지킨 요청의 출력 | 57만 토큰 | 45만 토큰 |
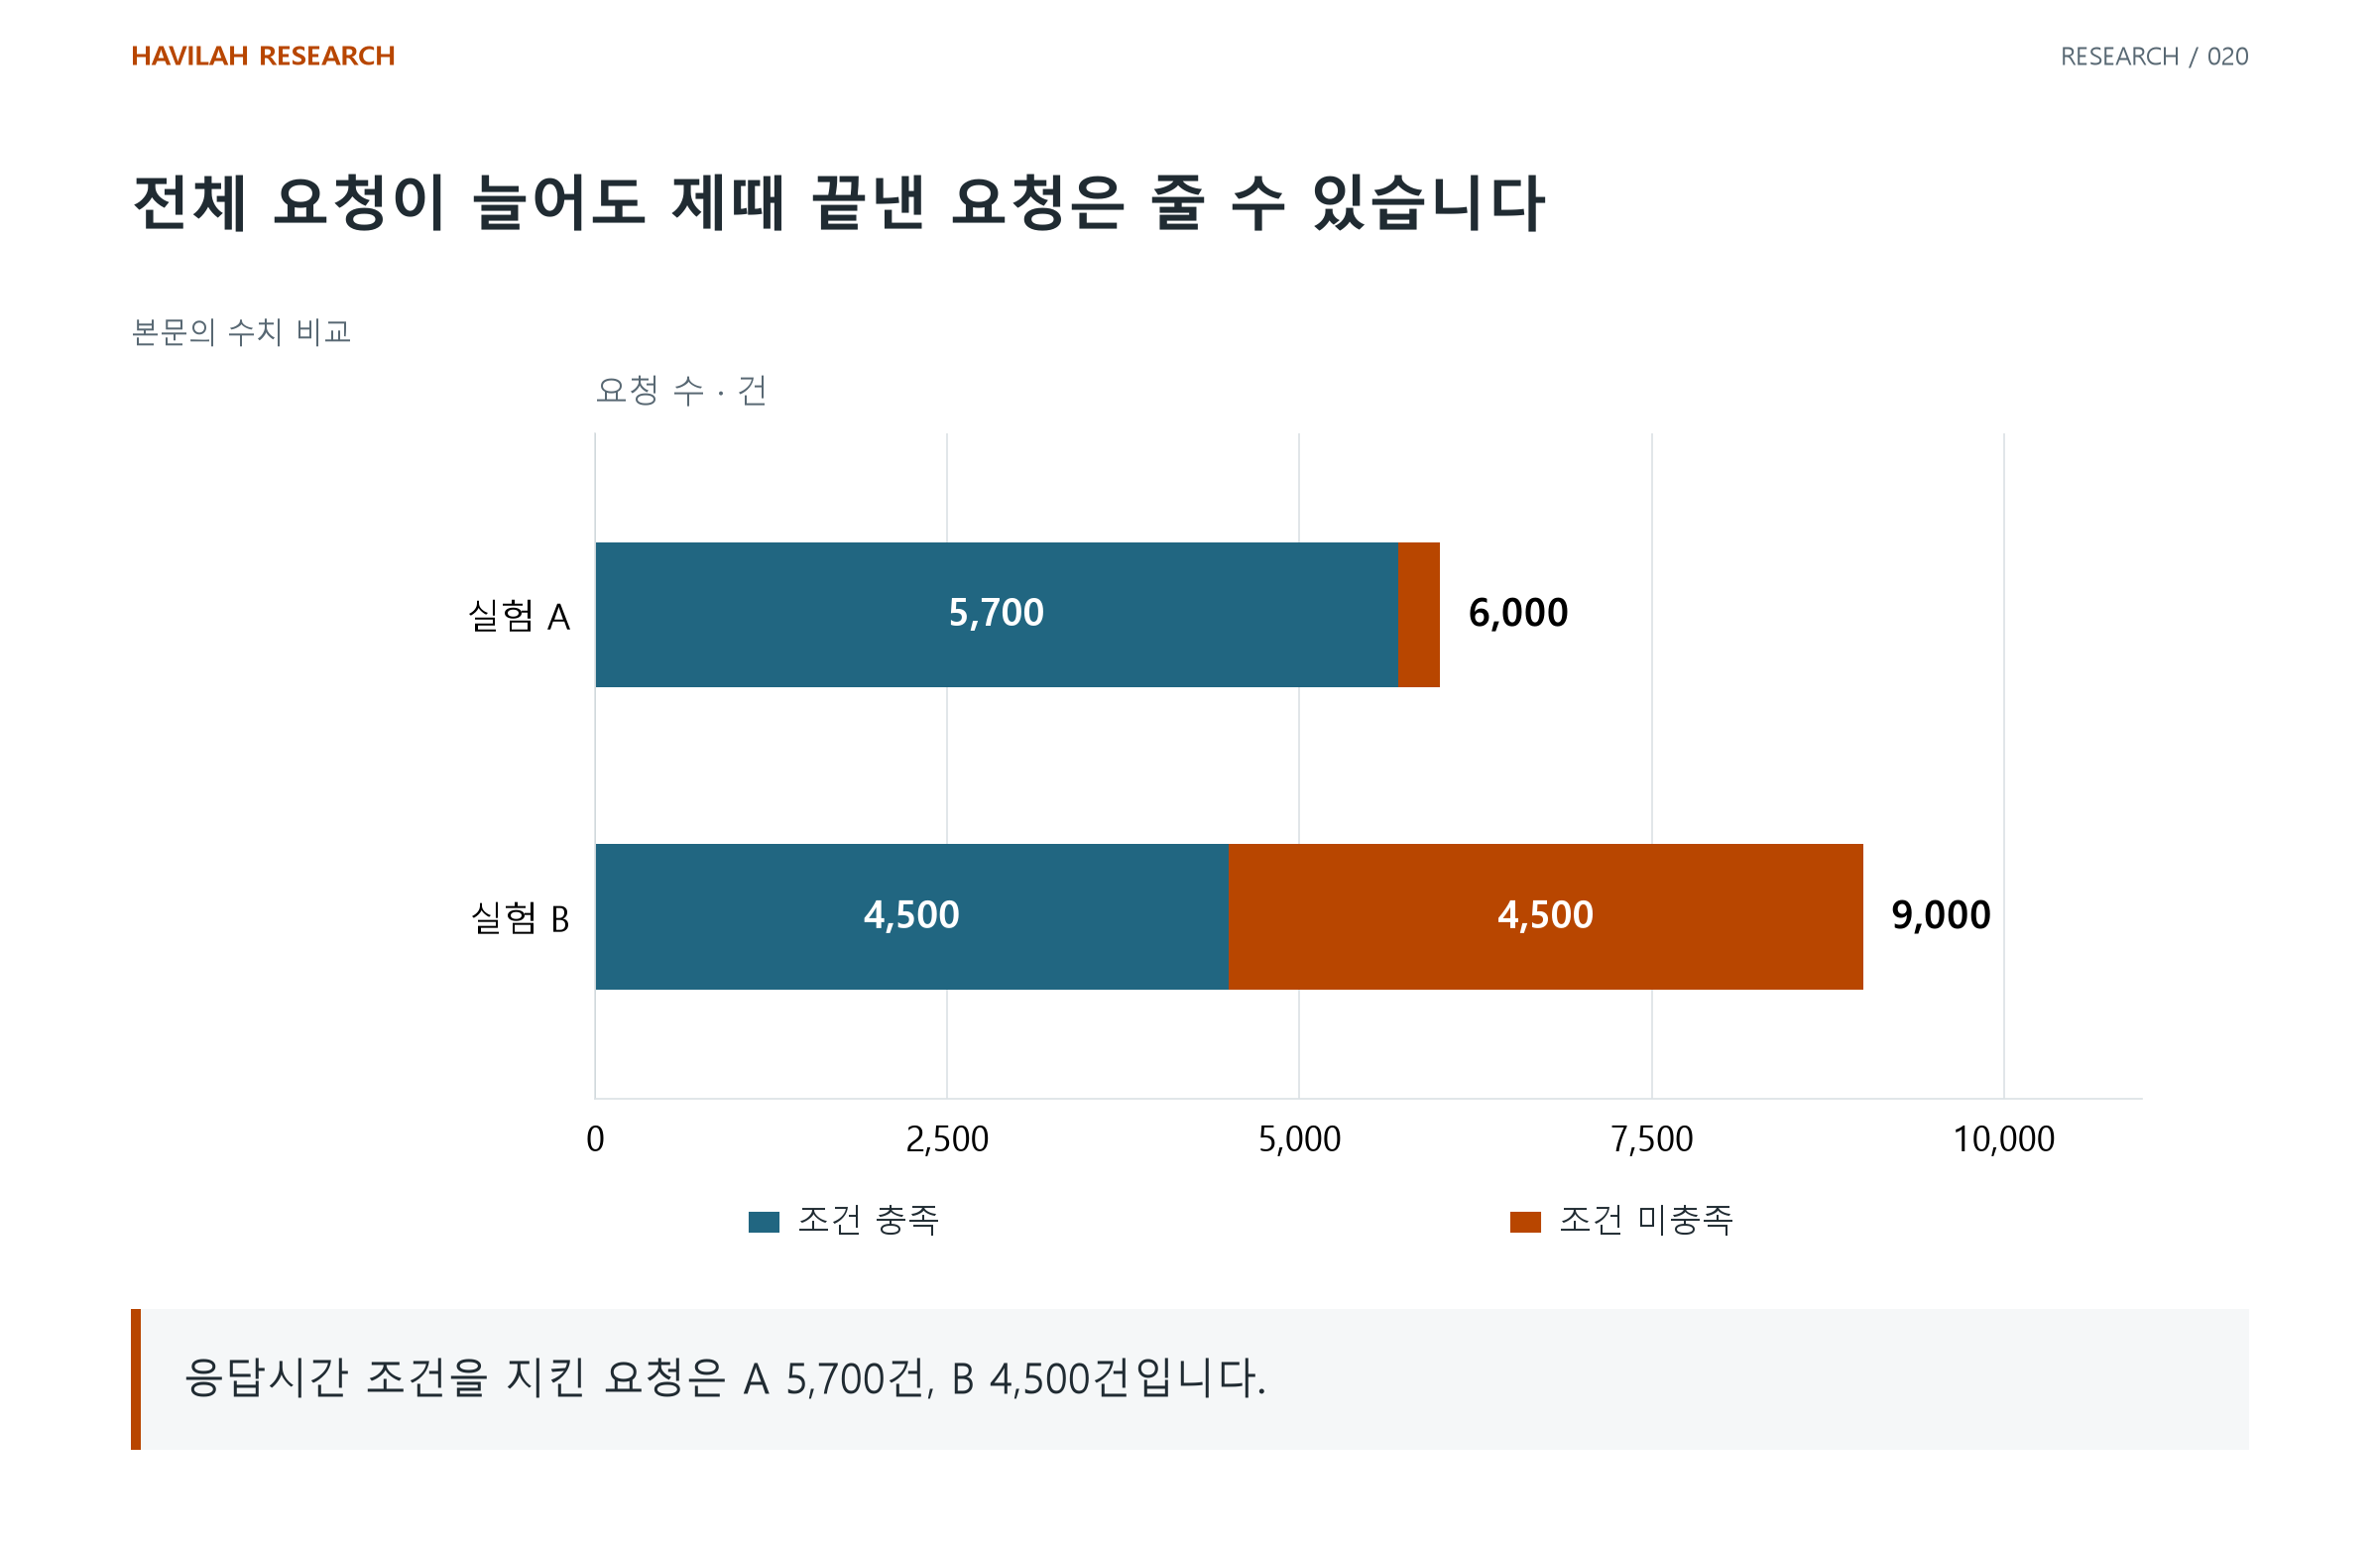
B의 전체 생성량은 많지만 조건을 지킨 요청의 출력은 적다. 이 예시에서는 ‘전체 출력 토큰당 비용’과 ‘시간 조건을 지킨 출력 토큰당 비용’이 서로 다른 결론을 줄 수 있다.
이 둘 중 후자가 실제 매출이라는 뜻은 아니다. 요금과 계약에 따라 시간 조건을 놓친 요청도 청구될 수 있다. 다만 환불, 서비스 크레딧과 고객 이탈까지 평가할 때 무시하기 어려운 차이다.
3. 좋은 처리량은 먼저 정의해야 계산할 수 있다
처리량에 시간 조건을 붙여 평가하는 관점을 굿풋(goodput)이라고 부른다. 다만 논문마다 집계 방식이 다르다. 위 예시에서는 한 요청이 첫 응답과 이후 생성 시간의 조건을 모두 만족한 경우에만 통과시키고, 그 출력량을 합산했다. 평균 시간만 비교하거나 두 조건을 따로 통과한 요청 수를 곱하지 않는다.
DistServe 논문은 목표 충족률을 유지할 수 있는 최대 요청 유입률을 굿풋으로 정의한다. 입력 처리와 출력 생성의 성격이 달라, 두 단계가 자원을 다투는 방식까지 고려해 이를 최적화한다. 여기서 얻을 판단 기준은 업무의 시간 목표가 어떤 자원 배치를 유리하게 만드는지 보라는 것이다.
모든 고객이 즉각적인 반응을 원하는 것도 아니다. 밤새 처리하는 대량 업무는 낮은 비용과 총량을 더 중시할 수 있다. 따라서 ‘빠르다’의 기준을 고객별로 정의한 뒤 비교해야 한다.
4. 분모를 바꾸면 서버 비용의 의미도 바뀐다
위 실험의 시간당 서버 비용이 양쪽 모두 6만원이라고 하자. 전체 생성량으로 나누면 A는 1,000 출력 토큰당 100원, B는 약 66.7원이다. 반면 시간 조건을 지킨 출력만 분모로 쓰면 A는 약 105.3원, B는 약 133.3원이다.
이 비용은 토큰별 원가 배분을 위한 가상 계산이다. 가격표나 실제 업체의 원가를 뜻하지 않는다. 요청의 출력 길이가 다르면 통과 요청 수에 평균 길이를 곱하기보다, 통과한 요청의 토큰을 직접 합산해야 한다.
서버 경제성을 읽을 때는 여기에 유료 사용 비율, 예약 용량, 네트워크와 운영비를 더해야 한다. 성능 개선으로 굿풋이 늘어도 수요가 부족하면 판매량이 같은 폭으로 늘지 않는다. 반대로 처리량이 같아도 장비 수를 줄여 계약을 유지할 수 있다면 비용 절감이 생긴다.
5. 성능표를 실제 고객 조건에 맞춰 다시 묻는다
모델 이름, 정확도 조건과 입출력 길이를 맞춘 뒤, 동시 사용자가 늘어날 때 시간 조건을 언제부터 놓치는지 확인한다. 평균뿐 아니라 늦게 끝나는 요청의 비율도 살핀다. 측정 구간에는 대기와 네트워크 시간이 포함되는지도 적는다.
더 빠른 칩이 좋은 사업이 되는 경로는 고객의 조건을 더 싸게 또는 더 많이 만족시키는 데 있다. 그 경로를 확인하려면 서버의 최대치와 고객에게 판매한 조건 사이의 간격을 계산해야 한다.
어떤 입력·출력 길이와 정확도에서 얻은 처리량인가?
두 시간 목표를 동시에 지킨 요청과 출력은 얼마나 되는가?
비용을 전체 출력으로 나눴는가, 조건을 지킨 출력으로 나눴는가?
성능 향상 이후 실제 유료 사용량이나 필요한 서버 수가 달라졌는가?