
AI가 예시 문제를 맞히면 같은 종류의 업무도 맡길 수 있을 것처럼 느껴진다. 그러나 고객명·수량·문장 순서가 바뀌거나 무관한 숫자가 섞였을 때에도 필요한 조건을 정확히 골라야 실제 업무에 쓸 수 있다.
평가는 정답 하나에서 끝나지 않는다. 어떤 변화에는 답이 유지돼야 하고, 어떤 변화에는 계산 결과나 행동이 달라져야 하는지 미리 정해 확인한다.
업무에 필요한 안정성은 익숙한 예시를 맞히는 능력과, 조건이 바뀐 새 사례에서도 필요한 관계를 지키는 능력을 함께 요구한다.
1. 벤치마크 결과에 문제와 관찰 시점을 붙인다
Apple의 GSM-Symbolic 연구 소개는 2024년 연구에서 산수 문장제의 템플릿으로 이름·수치·조건을 변형해 평가한 방법을 설명한다. 연구 대상 모델에서 문제 변형에 따른 성능 차이와 불필요한 절의 영향을 관찰했다.
이 관찰을 모든 미래 모델의 성능이나 의식·이해 여부에 대한 결론으로 확대하지 않는다. 특정 평가에서 취약점이 발견됐다는 사실과 모든 업무에서 같은 오류가 생긴다는 말도 다르다.
실무에서 가져올 질문은 명확하다. 우리 업무에서 허용되는 변화에도 결과가 안정적인가? 현재 사용할 모델·도구·입력 형식으로 따로 확인한다.
2. 답이 같아야 하는 변화와 달라져야 하는 변화를 나눈다
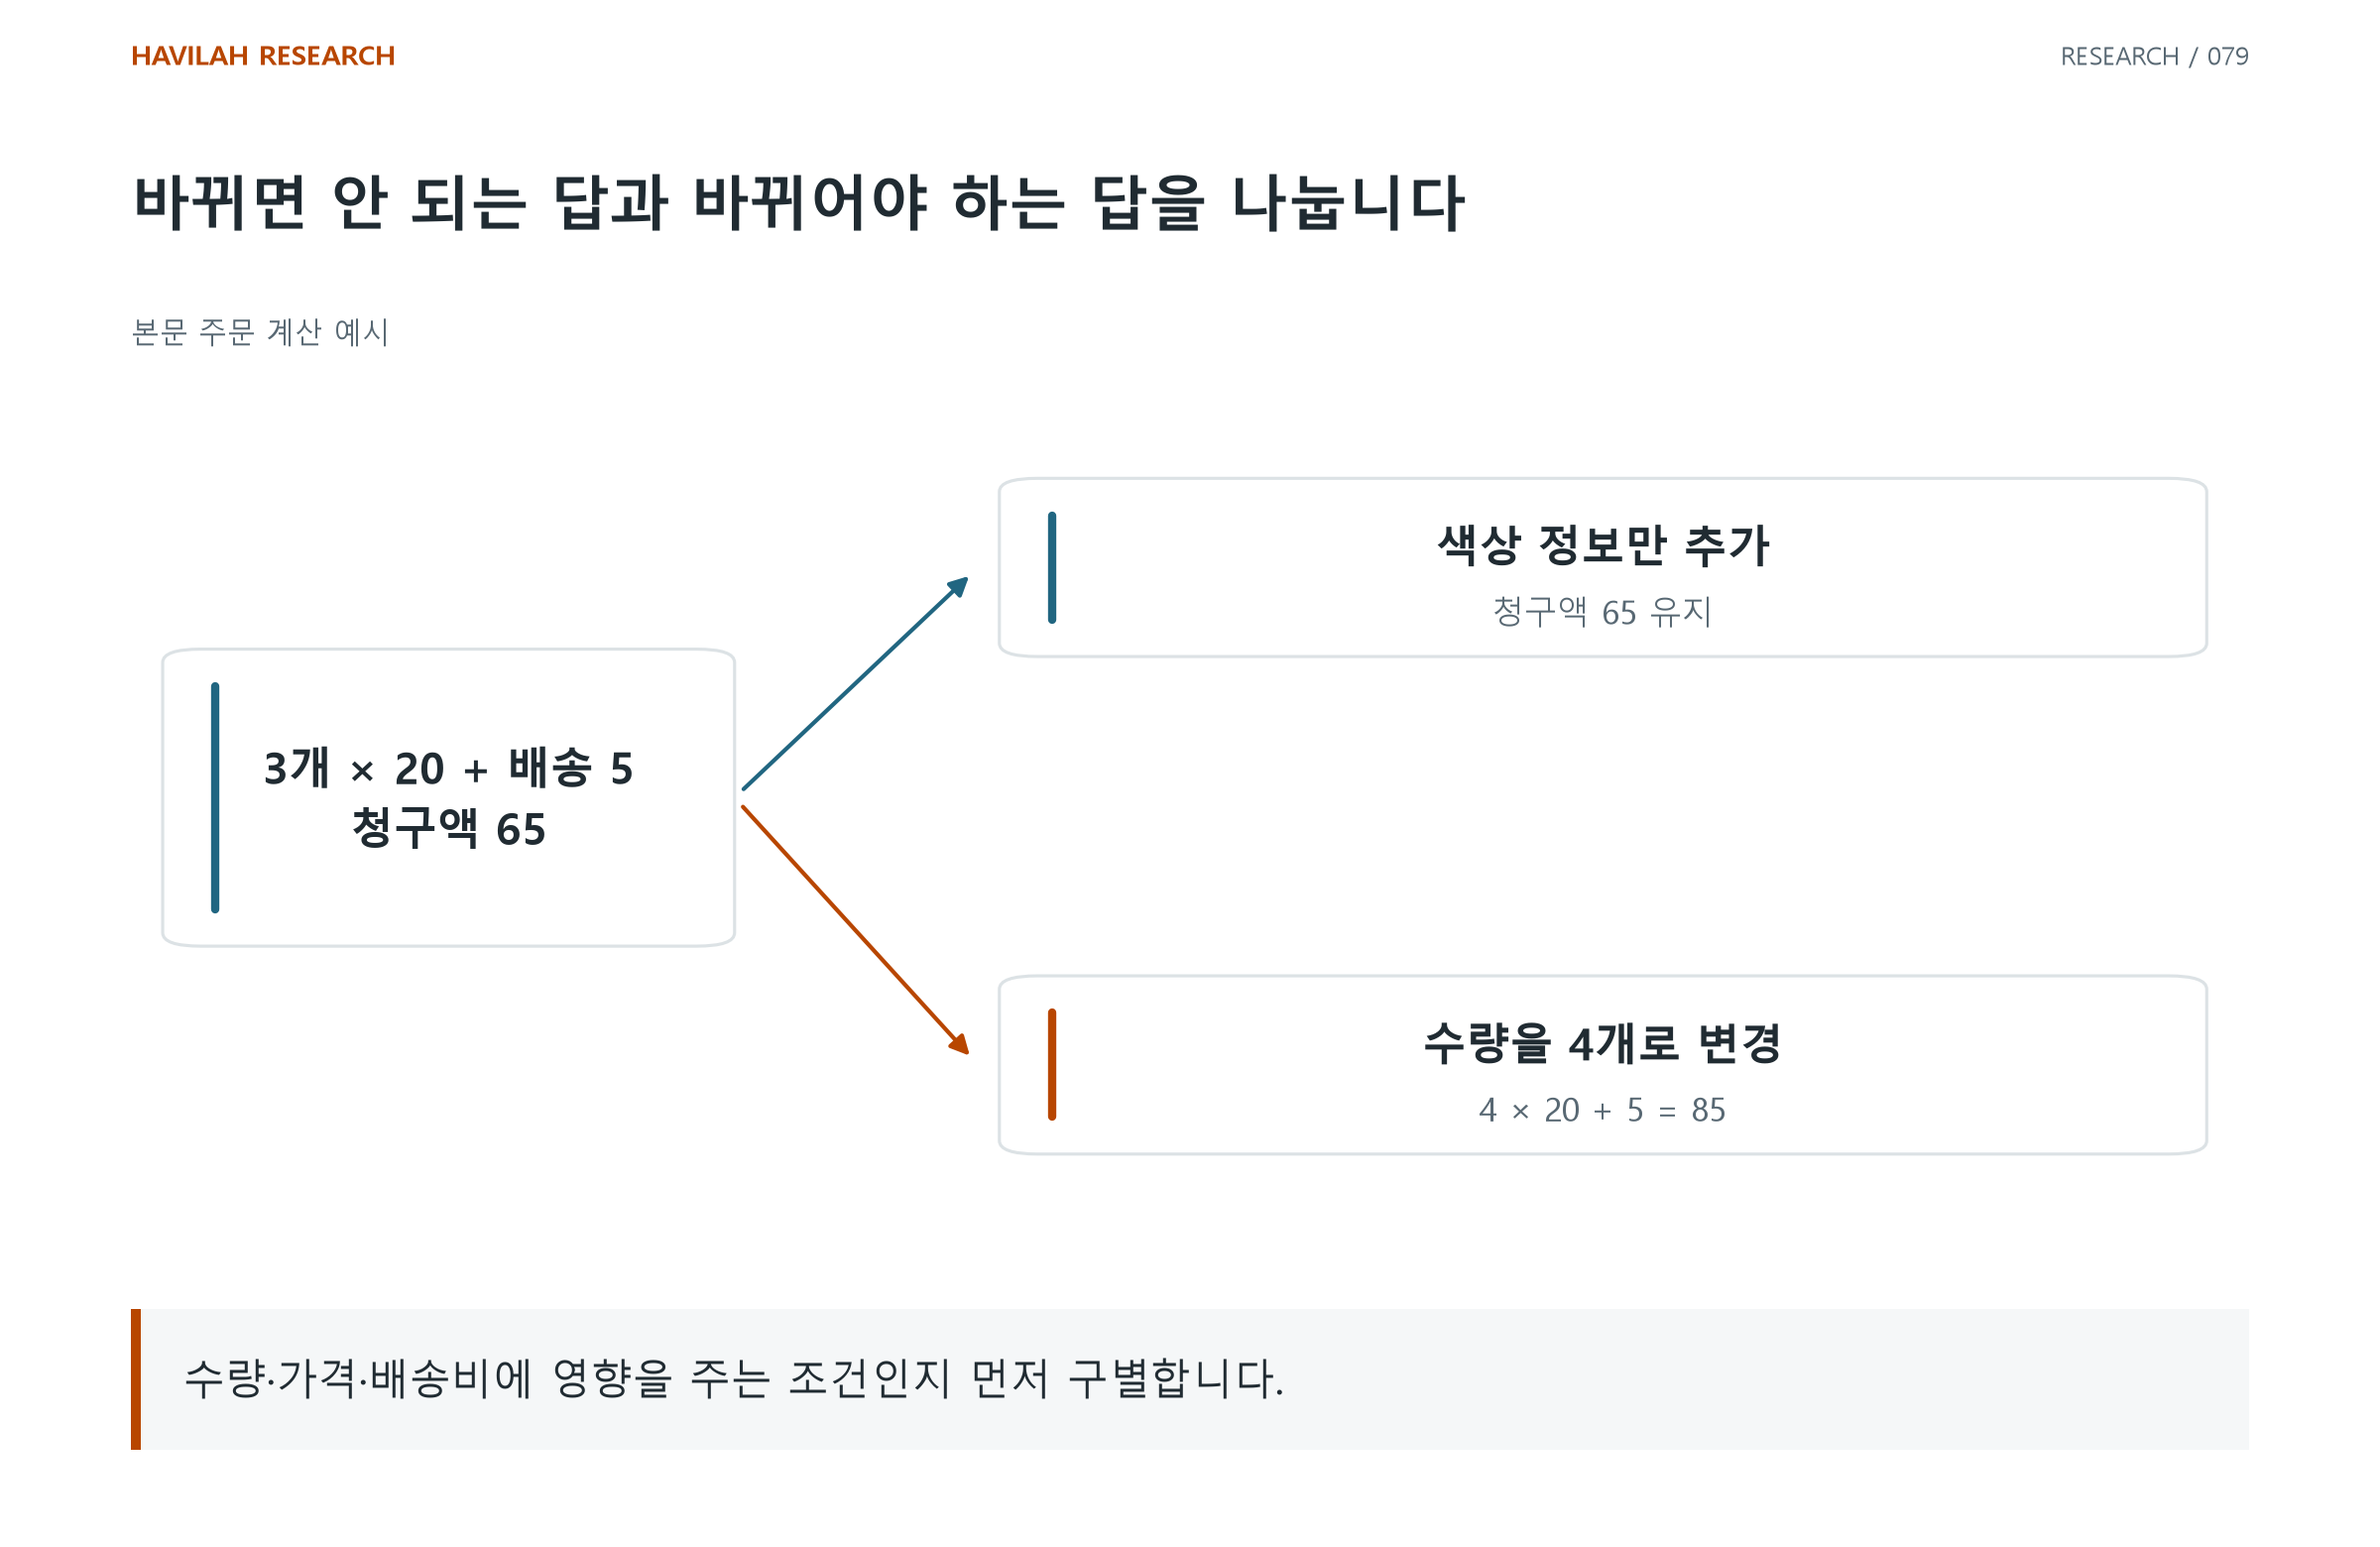
같은 주문의 고객명을 바꾸거나 문장 순서를 바꿔도 청구액은 유지돼야 한다. 수량·단가·배송비가 바뀌면 청구액은 새 조건에 맞게 바뀌어야 한다.
무관해 보이는 문장이 실제 계약 조건일 수도 있다. 무엇이 무관한지는 목표와 업무 규칙에서 정한다. 결과가 달라졌다는 이유만으로 오류라고 부르기 전에, 문제의 의미도 달라졌는지 확인한다.
변형 평가에서 중요한 것은 문장을 많이 만드는 양보다 기대되는 관계를 사전에 정의하는 일이다.
3. 작은 예제로 숫자 선택과 계산을 따로 본다
가상의 주문이 3개·개당 20·배송비 5라면 청구액은 65다. “제품 중 2개는 초록색이며 가격은 같다”는 설명을 추가해도 65다. 그 숫자 2를 할인이나 차감으로 사용하면 문제의 조건을 잘못 읽은 것이다.
수량을 4개로 바꾸면 청구액은 85다. 이름만 바꾸는 경우와 수량을 바꾸는 경우를 같은 종류의 테스트로 취급하지 않는다. 이는 실제 고객 자료가 아닌 손으로 검산한 예제다.
계산 도구를 붙이면 산술을 확인하는 데 도움이 된다. 그러나 도구에 잘못된 수량이나 식을 전달할 수도 있다. 조건을 골라 식을 만드는 단계와 식을 계산하는 단계를 각각 대조한다.
4. 총 정답률 아래에 어떤 실패가 남았는지 기록한다
이름 변경·숫자 변경·문장 재배치·무관 설명 추가를 나누어 결과를 기록한다. 한 유형에서 잘 풀고 다른 유형에서 반복해서 실패하면 평균 정답률만으로 이를 가릴 수 있다.
처음부터 평가하지 않은 입력 누락·모순·지원 범위 밖의 요청도 확인한다. 이런 경우 정답을 꾸며내는지, 필요한 정보를 묻거나 한계를 표시하는지 본다.
모델과 도구 버전·설정·실행 시각을 남긴다. 같은 문제를 여러 번 실행했다면 시도 횟수와 실패도 포함하고, 좋은 답 하나만 골라 대표 결과로 보이지 않게 한다.
5. 평가 결과를 맡길 업무의 범위와 연결한다
변형 문제를 통과했다고 해서 모든 실제 자료·실행 권한까지 검증된 것은 아니다. 문서 초안·계산 보조·주문 실행처럼 결과의 용도에 맞는 확인 단계를 정한다.
실제 자료와 조건을 닮은 별도 평가에서 오류·수정 비용·확인 시간을 함께 살핀다. 평가 문제를 보며 계속 프롬프트를 고쳤다면 그 문제들은 개발에 사용한 사례다. 새로운 평가 사례도 남겨 둔다.
정답을 만든 문장뿐 아니라 입력·기대값·실제 결과·실패 유형을 보관하면 모델을 바꿨을 때도 비교할 수 있다. 업무의 안정성은 그 기록을 통해 확인한다.
계산 업무 한 건으로 세 문제를 만든다. 이름만 바꾼 문제, 무관한 문장을 더한 문제, 핵심 숫자를 바꾼 문제다. 기대 답을 먼저 계산한 다음 실제 답·오류 유형·모델과 프롬프트 버전을 함께 기록해 보자.